
Technische schuld in software: wanneer snelle keuzes later duur worden
Technische schuld ontstaat wanneer snelle of suboptimale technische keuzes later extra werk veroorzaken. Lees wanneer dat acceptabel is, wanneer het gevaarlijk wordt en hoe je het als bedrijf herkent.
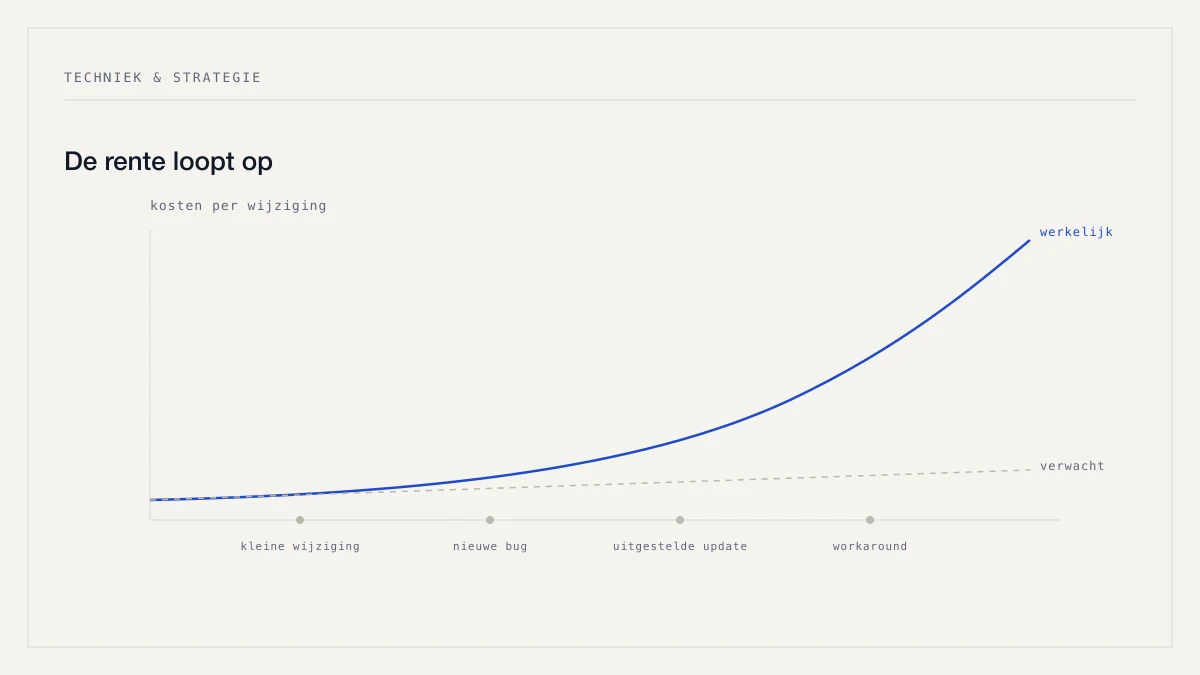
Software kan jarenlang goed lijken te functioneren en tegelijk steeds moeilijker worden om aan te passen. Een functie die vroeger een paar dagen kostte, vraagt ineens weken. Kleine wijzigingen veroorzaken onverwachte bugs. Een update van een library blijkt een compleet migratieproject. En uiteindelijk begrijpt nog maar één ontwikkelaar hoe een cruciaal onderdeel werkt. Dat zijn de klassieke signalen van technische schuld.
Technische schuld betekent niet simpelweg dat code slecht is. Het gaat om technische keuzes die nu tijd besparen of complexiteit verbergen, maar later extra werk veroorzaken. Dat kan bewust gebeuren: eerst alleen de primaire workflow bouwen, niche-uitzonderingen tijdelijk handmatig afhandelen en later gecontroleerd uitbreiden. Dat is iets heel anders dan data dubbel opslaan, businessregels overal verspreiden, geen tests schrijven en niemand laten weten welke versie leidend is. In beide gevallen is iets uitgesteld, maar alleen het eerste is een verstandige fasering.
De relevante vraag is daarom niet óf je software technische schuld heeft — vrijwel ieder digitaal product bevat concessies. De vraag is welke technische keuzes toekomstige wijzigingen aantoonbaar duurder of riskanter maken, en of die keuzes bewust en beheerst zijn genomen.
Wat technische schuld is, en wat het niet is
De vergelijking met een lening werkt goed. Je bespaart vandaag tijd en betaalt later rente in de vorm van extra ontwikkeltijd, meer regressies, moeizamere upgrades, langere debugging en kostbare migraties. Technische schuld is daarmee geen puur codekwaliteitsthema maar heeft directe gevolgen voor de snelheid van doorontwikkeling, de onderhoudskosten, de betrouwbaarheid en de continuïteit.
Het is bovendien iets anders dan oude software. Een applicatie kan oud zijn en goed onderhouden, terwijl een relatief nieuw systeem binnen een jaar veel schuld kan opbouwen. Leeftijd is geen maatstaf; belangrijker is of dependencies worden beheerd, of de architectuur begrijpelijk is, of kritieke flows zijn getest, of het team veilig kan wijzigen, of data goed is gemodelleerd en of er bruikbare documentatie bestaat.
Het is evenmin hetzelfde als bugs. Een bug is zichtbaar fout gedrag; technische schuld kan jarenlang verborgen blijven. Een functie kan correct werken terwijl iedere wijziging eraan drie keer zoveel werk kost. De gebruiker merkt dat niet, de organisatie wel — via langere doorlooptijden, hogere ontwikkelkosten en meer risico.
En niet iedere shortcut is slecht. Een bedrijf hoeft niet vanaf dag één iedere toekomstige mogelijkheid uit te werken; dat zou juist over-engineering zijn. Een eerste versie zonder uitgebreide rapportages, bulkacties, tweede integratie of zeldzame uitzonderingsflow is normale productscope. De grens wordt belangrijk zodra een tijdelijke keuze het fundament aantast. Bouw je versie één met één gebruikersrol terwijl het autorisatiemodel uitbreidbaar is, dan is dat prima fasering. Controleer je in plaats daarvan overal in de code op één specifiek e-mailadres van de beheerder, dan werkt dat vandaag en moet je die logica op tientallen plekken vervangen zodra er meerdere beheerders, teams of rollen komen. Dat is schuld.
Bewuste en onbewuste schuld
Het onderscheid dat er in de praktijk het meest toe doet, is of de concessie expliciet is gemaakt. Bij bewuste schuld weet iedereen dat een oplossing niet ideaal is, waarom die toch is gekozen, en wanneer hij wordt vervangen. Dat kan zakelijk rationeel zijn wanneer snelheid echt telt, het risico beperkt is, de schuld zichtbaar blijft en de vervanging haalbaar is — vergelijkbaar met bewust tijdelijk lenen.
Problematischer is schuld die ontstaat zonder dat iemand de gevolgen overziet: door onvoldoende architectuurkennis, ontbrekende tests, onduidelijke verantwoordelijkheden, snelle hacks die permanent worden, verouderde dependencies of slechte datamodellering. Daar bestaat geen terugbetalingsplan, en de organisatie merkt de schuld pas wanneer iedere wijziging moeizamer gaat.
De duurste vormen zitten bovendien zelden in losse code maar in de architectuur: modules die sterk aan elkaar gekoppeld zijn, businesslogica verspreid over frontend, database en scripts, hetzelfde gegeven dat op meerdere plekken als waarheid wordt bijgehouden, een verouderd datamodel dat nieuwe functionaliteit blokkeert, één externe service die overal direct wordt aangeroepen, of autorisatieregels die niet centraal zijn gemodelleerd. Zulke problemen zijn moeilijk lokaal te repareren en beïnvloeden steeds meer nieuwe functionaliteit.
Een voorbeeld maakt dat concreet. Wordt een orderstatus op vijf plekken als vrije tekst opgeslagen — de een schrijft "nieuw", de ander "in behandeling", een derde "bezig" — dan werkt dat zolang mensen het lezen. Wil het bedrijf vervolgens rapportages, klantnotificaties, automatische facturatie, filtering en integraties, dan blijkt dezelfde status overal anders gespeld of geïnterpreteerd. De oorspronkelijke snelle keuze werkt dan als vermenigvuldigende schuld: iedere nieuwe functie moet die inconsistentie opnieuw omzeilen.
Hoe je het herkent zonder code te lezen
Je hoeft geen ontwikkelaar te zijn om de signalen op te merken. Het eerste is dat kleine wijzigingen steeds meer tijd kosten, met opmerkingen als "dat raakt heel veel andere onderdelen" of "dat systeem is lastig aan te passen". Niet iedere complexe wijziging bewijst schuld, maar kosten eenvoudige veranderingen structureel disproportioneel veel werk, dan is dat een signaal.
Het tweede is dat iedere wijziging nieuwe bugs veroorzaakt, wat vaak wijst op sterke koppeling tussen onderdelen, onvoldoende testdekking of onduidelijke businessregels — software wordt dan fragiel. Het derde is dat slechts één persoon bepaalde code durft aan te raken, door gebrek aan documentatie, onduidelijke architectuur, complexe legacycode of weinig kennisdeling; dat is tegelijk een continuïteitsrisico.
Het vierde signaal is dat updates jarenlang worden uitgesteld, of het nu frameworkversies, libraries, databaseversies of plugins betreft. Hoe langer dat duurt, hoe groter de sprong later wordt: een kleine regelmatige update verandert dan in een migratieproject. Het vijfde is dat workarounds permanent worden — "dit maken we later netjes" terwijl dat later nooit komt en uitzonderingen zich opstapelen. Het zesde is dat dezelfde logica op meerdere plekken bestaat, bijvoorbeeld prijsberekening in de frontend, de backend en een exportscript; lopen die uit elkaar, dan weet niemand meer welke berekening leidend is. En het zevende is dat niemand snel kan uitleggen hoe het systeem in elkaar zit, zodat iedere wijziging begint met archeologisch onderzoek.
Wanneer schuld acceptabel is, en wanneer niet
Niet iedere vorm hoeft onmiddellijk opgelost. Een rationele afweging kijkt naar vier vragen. Is de schuld bewust — is duidelijk welke concessie is gemaakt, waarom, en welke gevolgen worden verwacht? Kan niemand dat uitleggen, dan valt de schuld ook niet te beheren. Is het risico beperkt? Een tijdelijke workaround in een intern rapport is iets anders dan een shortcut in betalingen, autorisatie, financiële data of data-integriteit; hoe bedrijfskritischer het onderdeel, hoe minder ruimte er is voor fragiele oplossingen. Is er een realistisch moment om op te ruimen? "Later" is geen planning, maar "voordat integratie X wordt toegevoegd" of "binnen het vierde kwartaal" wel. En blijft de schuld zichtbaar? Schuld die in de backlog, architectuurdocumentatie of het risico-overzicht staat, kan worden beheerd; verborgen schuld vermenigvuldigt zich ongecontroleerd.
Sommige fundamenten lenen zich slecht voor uitstel. Zijn kernrelaties of transacties verkeerd gemodelleerd, dan wordt iedere toekomstige functie fragieler. Rechten alleen in de frontend controleren is geen bruikbare shortcut, want toegang moet betrouwbaar worden afgedwongen. API-keys hardcoden of in publieke code zetten is geen fasering maar een beveiligingsprobleem. Een productieapplicatie zonder passende herstelmogelijkheid bouwt operationeel risico op. En niet iedere regel code hoeft getest, maar bedrijfskritische workflows volledig zonder regressiebescherming laten groeien, wordt later duur.
Prioriteren doe je vervolgens op impact. Schuld die raakt aan security, data-integriteit, betalingen, autorisatie of bedrijfscontinuïteit heeft hoog risico. Schuld die iedere nieuwe feature vertraagt — bijvoorbeeld een centraal datamodel dat niet meer past — vormt een ontwikkelrem. Een rommelig onderdeel dat bijna nooit verandert kan voorlopig minder urgent zijn dan een kernmodule waar wekelijks aan wordt gewerkt. En soms krijgt schuld een externe deadline, wanneer een library end-of-life nadert, een API-versie stopt of een hostingplatform verandert.
Dependencies, tests en documentatie
Moderne software gebruikt frameworks, libraries en externe packages, en dat is normaal en meestal wenselijk — je wilt geen authenticatieprotocol, databaseclient, routing of cryptografische primitieven zelf uitvinden. De simpele stelling dat veel dependencies slecht zijn, klopt daarom niet. Belangrijker is of er actieve projecten worden gebruikt, of versies worden bijgehouden, of securityupdates worden gevolgd en of er een upgradepad bestaat.
Uitgestelde updates worden wel schuld. Een project dat jarenlang op oude versies blijft draaien, moet uiteindelijk meerdere major-versies tegelijk overbruggen, met een grotere kans op breaking changes, incompatibiliteit, ontbrekende patches en een bredere testscope. Regelmatig onderhoud voorkomt dat één update later een groot migratieproject wordt; wat er na livegang gebeurt beschrijft hoe dat werk eruitziet.
Testing maakt technische schuld niet onmogelijk, maar goede testbaarheid maakt veilig verbeteren veel makkelijker. Er bestaan unit tests, integratietests, end-to-end tests en acceptatietests, en de relevante vraag is niet hoeveel tests er zijn maar of de kritieke risico's worden afgedekt. Duizenden oppervlakkige tests kunnen minder waarde hebben dan een kleinere set rond financiële berekeningen, rechten, orders en kritieke integraties. Teststrategie hoort risicogestuurd te zijn.
Documentatie voorkomt niet dat code slecht wordt, maar zonder documentatie wordt complexe software sneller afhankelijk van individuele kennis. Een architectuuroverzicht, het datamodel, de belangrijkste businessregels, het deploymentproces, API-contracten en runbooks zijn daarvoor genoeg. Het doel is niet zoveel mogelijk documenten schrijven, maar dat een andere competente ontwikkelaar het systeem kan begrijpen, aanpassen en herstellen.
Over-engineering is ook schuld
Sommige teams proberen schuld te voorkomen door alles vanaf het begin future-proof te maken. Een kleine applicatie die direct wordt opgezet met microservices, een eventbus, complexe orchestration en meerdere databases, levert zonder concreet schaalprobleem vooral extra operationele complexiteit op. Over-engineering veroorzaakt dus zelf technische schuld.
Een onderhoudbare architectuur is meestal begrijpelijk, passend bij het probleem, uitbreidbaar op de assen waar groei wordt verwacht, en niet ingewikkelder dan nodig. Voor een mkb-webapp kan een goed gestructureerde monolithische applicatie rationeler zijn dan tientallen services. Schaalbaarheid moet aansluiten op de werkelijke groeivraag, niet op een hypothetische.
Hoe het financieel doorwerkt
Technische schuld verschijnt zelden als aparte factuurregel; de kosten zijn indirect. Een feature die normaal drie dagen kost maar door de architectuur acht dagen vraagt, laat vijf dagen rente zien op eerdere keuzes. Op organisatieniveau zie je dat terug in langere roadmaps, hogere onderhoudsbudgetten, minder ruimte voor innovatie, meer incidenten en grotere afhankelijkheid van specialisten. Diezelfde factoren bepalen vooraf de scope in wat een webapplicatie kost.
Je hoeft daarvoor geen perfecte financiële formule te hebben; patronen meten volstaat. Vergelijk de doorlooptijd van vergelijkbare wijzigingen, tel het aantal regressies, meet de tijd besteed aan incidenten, breng de updateachterstand in kaart, noteer welke onderdelen telkens opnieuw moeten worden aangepast en waar afhankelijkheid van één specialist bestaat. Zo wordt technische schuld minder abstract en beter bespreekbaar met niet-technische besluitvormers.
Refactoren of herbouwen?
Een veelgemaakte fout is de conclusie dat rommelige code betekent dat alles opnieuw moet. Een rewrite is minstens zo riskant, omdat bestaande kennis dan opnieuw moet worden geïmplementeerd — inclusief de uitzonderingen die niemand meer kan uitleggen. Eerst moet duidelijk zijn welke onderdelen daadwerkelijk problematisch zijn, welke nog goed functioneren, of geleidelijke refactoring mogelijk is en welke businessregels behouden moeten blijven.
Gerichte refactoring is sterk wanneer het probleem lokaal is, testdekking kan worden opgebouwd en de architectuur stap voor stap verbeterbaar is. Volledige herbouw wordt relevanter wanneer de fundamentele architectuur niet meer aansluit, technologie end-of-life is, het data- of beveiligingsmodel structureel fout zit, of repareren duurder en riskanter wordt dan vervangen. Ook dan hoort die beslissing op analyse te rusten en niet op frustratie. Voor websites loopt diezelfde afweging via optimaliseren, redesignen, herbouwen of replatformen.
Je kunt technische schuld daarbij grofweg in vier categorieën indelen, en per item beoordelen op impact, veranderfrequentie en risico.
| Type | Voorbeeld | Mogelijke impact |
|---|---|---|
| Code | duplicatie, verspreide logica | tragere wijzigingen |
| Architectuur | sterke koppeling, verkeerd datamodel | brede impact bij changes |
| Dependencies | achterhaalde frameworks/libraries | security- en migratierisico |
| Proces/kennis | geen tests/documentatie | meer fouten en persoonsafhankelijkheid |
Niet ieder item hoeft naar nul; het doel is beheersbaarheid.
Vragen die je aan een ontwikkelpartner kunt stellen
Je hoeft niet zelf te beoordelen of iedere class netjes is geschreven, maar je kunt wel doorvragen:
- Welke technische schuld is op dit moment bekend?
- Welke onderdelen vertragen nieuwe ontwikkeling?
- Welke dependencies zijn verouderd?
- Welke kritieke flows zijn geautomatiseerd getest?
- Welke architectuurkeuzes zijn bewust tijdelijk?
- Welke onderdelen zijn sterk afhankelijk van één persoon?
- Welke technische risico's moeten binnen twaalf maanden worden aangepakt?
- Wat gebeurt er als we niets doen?
Een professionele partner hoeft niet te beweren dat er geen technische schuld is; die moet kunnen uitleggen welke schuld er is en hoe ermee wordt omgegaan.
De zakelijke vraag achter technische kwaliteit
Technische schuld volledig voorkomen is niet realistisch. Software ontwikkelt zich samen met een bedrijf: er komen nieuwe eisen, technologie verandert, interfaces worden aangepast, en een architectuur die vandaag past kan over drie jaar andere beperkingen kennen. Het doel is dus niet nul schuld, maar schuld zichtbaar houden, hem bewust nemen waar dat rationeel is, en voorkomen dat de rente de ontwikkeling gaat beheersen.
Technische kwaliteit wordt soms gepresenteerd als iets waar alleen developers om geven, terwijl het uiteindelijk bepaalt hoe makkelijk een digitaal product kan veranderen, groeien, herstellen, worden overgedragen en veilig blijven. Een bedrijf merkt slechte technische kwaliteit meestal pas wanneer een wijziging urgent wordt — en dan is de schuld al opgebouwd. Hoe je die kwaliteit eerder beoordeelt staat in een apart artikel.
De beste aanpak is dan ook niet ieder project maximaal uitgebreid bouwen, maar onderscheid maken tussen functionaliteit die kan wachten en fundament dat vanaf het begin betrouwbaar moet zijn. Een dashboard kan later. Een tweede rapport kan later. Een zeldzame uitzondering kan tijdelijk handmatig. Maar data-integriteit, autorisatie, cruciale businessregels en een onderhoudbare basis zijn achteraf veel moeilijker te repareren.
Dat is de kern van technische schuld: snelheid vandaag is alleen waardevol als je er morgen niet disproportioneel voor hoeft te betalen. Bestaande code gericht opruimen hoort bij redesign en optimalisatie.
Bronnen
Dit artikel is opgesteld op basis van het onderzoeksdossier Digitale techniek & strategie voor zakelijke websites, webapps en digitale producten.
Belangrijkste bronnen uit het dossier:
- Atlassian — definitie, gevolgen en voorbeelden van technical debt
- SAP — bewuste versus onbewuste technische schuld
- CISQ — onderhoudbaarheid van software
- Microsoft — design for testability
- Qt — premature optimization en over-engineering
- NIST — data-integriteit en securityprincipes
- OWASP — veilige softwareontwikkeling
- software-engineeringbronnen uit het dossier over documentatie, dependencies en lifecyclekosten
De bronnen zijn gebruikt als onderbouwing voor de technische principes; zakelijke voorbeelden en besliskaders zijn vertaald naar de context van Nederlandse bedrijven en digitale producten.