
Wat gebeurt er na livegang? Technisch onderhoud van websites en webapps
Een website of webapp is na livegang niet klaar. Updates, backups, monitoring, logging, security, dependencies en herstelprocedures bepalen of het digitale product ook maanden en jaren later betrouwbaar blijft.
Een website of webapplicatie kan op vrijdag perfect worden opgeleverd en op maandag alweer veranderd zijn. Niet omdat iemand de code heeft aangepast, maar omdat de omgeving eromheen voortdurend beweegt. Een dependency krijgt een beveiligingsupdate, een externe API verandert, een certificaat verloopt, de database groeit, een third-party dienst valt uit, een browser wijzigt zijn gedrag, een gebruiker ontdekt een fout die tijdens de tests niet optrad, of een backup blijkt bij herstel niet compleet.
Livegang is daarom geen eindpunt maar het begin van de operationele levensfase van het product. Toch wordt technisch onderhoud vaak teruggebracht tot één vage regel in een offerte: onderhoud inbegrepen. Dat zegt niets over wat er werkelijk wordt gecontroleerd, wat periodiek wordt bijgewerkt, welke problemen automatisch worden gesignaleerd, wie verantwoordelijk is en hoe herstel verloopt als er iets misgaat. De nuttige vraag is niet of je een onderhoudspakket hebt, maar welke technische processen dit product veilig, beschikbaar en onderhoudbaar houden nu het eenmaal live staat.
Onderhoud is iets anders dan doorontwikkeling
Die twee worden commercieel voortdurend op één hoop gegooid, terwijl het verschillend werk is met verschillende budgetten. Technisch onderhoud houdt het bestaande product gezond: securitypatches, dependency-updates, backups controleren, monitoring, certificaten, bugfixes en compatibiliteitsreparaties. Doorontwikkeling verandert het product functioneel — een nieuwe rapportage, een klantportaal, een extra betaalmethode, een andere workflow, een CRM-integratie.
Een onderhoudscontract dat suggereert alles te dekken maar dat onderscheid niet maakt, leidt in de praktijk vaak tot discussie. De partij die betaalt denkt aan doorontwikkeling, de partij die levert aan beheer. Het loont om die grens vooraf op te schrijven, ook als beide bij dezelfde leverancier liggen.
Hoeveel onderhoud nodig is, hangt bovendien sterk af van wat er draait. Een grotendeels statische bedrijfswebsite vraagt iets heel anders dan een klantportaal met accounts, persoonsgegevens, betalingen, integraties en dagelijkse transacties. Het werk moet aansluiten op risico en complexiteit, niet op een standaardpakket dat voor ieder project hetzelfde is.
Waarom software verandert terwijl je er niets aan doet
Een digitaal product staat zelden op zichzelf. Het draait op applicatiecode die leunt op een framework, libraries, een database, hosting, externe API's, browsers, DNS, e-mail en analytics — en al die onderdelen hebben hun eigen levenscyclus. Daardoor kan software die zelf niet verandert alsnog onderhoud nodig krijgen.
Dependencies zijn daarin het duidelijkst zichtbaar. Moderne software gebruikt bestaande frameworks en libraries, en dat is meestal verstandig: je wilt geen authenticatieprotocol, databaseclient, routing of cryptografische primitieven zelf uitvinden. Maar iedere dependency moet wel beheerd worden, want ze kunnen bugs bevatten, een kwetsbaarheid krijgen, end-of-life raken of incompatibel worden met een nieuwere omgeving. Daarom hoort periodiek te worden gecontroleerd welke versies er draaien.
Blind alles automatisch upgraden is daarbij net zo min professioneel onderhoud, want een update kan breaking changes bevatten. De normale gang van zaken is dat een nieuwe versie beschikbaar komt, dat iemand de impact beoordeelt, dat er wordt getest en dat de wijziging gecontroleerd wordt uitgerold — waarbij die route zorgvuldiger wordt naarmate het systeem kritischer is. Wat je vooral wilt voorkomen is jarenlang achterlopen. Een klein versieverschil is beheersbaar; van versie tien naar versie zeventien springen betekent meerdere breaking changes tegelijk oplossen, met een veel grotere testscope. Dat is een van de manieren waarop technische schuld ontstaat, en het is precies het scenario dat regelmatig onderhoud goedkoop maakt in vergelijking met uitstel.
Security stopt niet bij oplevering
Een website wordt niet één keer veilig gemaakt en is daarna klaar. Er worden continu nieuwe kwetsbaarheden ontdekt, dus securityonderhoud bestaat uit dependency-updates, accountbeheer, credentialrotatie, monitoring, logging, vulnerability checks en patching. Een goed ontwerp voorkomt veel problemen, maar zelfs sterke software moet worden bijgehouden: een library krijgt een CVE, een medewerker vertrekt maar houdt toegang, een API-key lekt, of er ontstaat een nieuw misbruikpatroon.
Bij zakelijke applicaties hoort daar expliciet accountbeheer bij. Een loginpagina is niet het einde van security; je moet ook weten welke accounts bestaan, welke rollen ze hebben, welke data ze mogen zien en wanneer toegang wordt ingetrokken. Een oud account van een vertrokken medewerker werkt technisch vaak gewoon door. Account lifecycle is daarmee geen eenmalige inrichting maar operationeel beheer.
Verrassend vaak zijn de problemen bovendien klein en administratief. Een verlopen certificaat, een ingetrokken API-key, een gewijzigd OAuth-secret of een niet-verlengd domein kan een applicatie volledig platleggen. Dat soort operationele assets hoort in een beheerd proces te zitten, met een eigenaar en een bewakingstermijn. Voor domeinen geldt dat extra scherp: DNS bepaalt waar niet alleen je website maar ook je e-mail, domeinverificaties en externe diensten gevonden worden, dus één verkeerd record raakt meer dan alleen de homepage.
Backups zijn nog geen herstel
"We hebben automatische backups" klinkt geruststellend en is hooguit de helft van het verhaal. Een backup is een kopie; herstel is een procedure. Drie vragen bepalen of je er werkelijk iets aan hebt.
De eerste is wat er wordt geback-upt. Afhankelijk van het product gaat het om de database, uploads, configuratie en belangrijke bestanden — alleen code backuppen is zinloos als alle klantdata in een database staat. De tweede is waar de backups staan. Draaien ze op exact dezelfde infrastructuur als productie, dan kan één storing beide raken, dus scheiding en retentie verdienen een bewuste keuze. De derde vraag is de belangrijkste: kunnen ze worden teruggezet? Een backup die nooit is teruggezet is een aanname, geen zekerheid. Een restoretest die de backup daadwerkelijk terugzet, de applicatie start en de data controleert, is het enige bewijs dat herstel mogelijk is.
Voor bedrijfskritische systemen helpt het om herstel in twee getallen uit te drukken. Een Recovery Point Objective zegt hoeveel recente data maximaal verloren mag gaan; staat die op één uur, dan accepteer je bij een ernstig incident ongeveer een uur aan wijzigingen kwijt te raken. Een Recovery Time Objective zegt hoe lang herstel maximaal mag duren. Niet iedere mkb-website heeft formele documentatie op dat niveau nodig, maar de onderliggende vragen blijven relevant: hoeveel data kunnen we missen, en hoe lang mogen we offline zijn?
Merken dat er iets misgaat, en begrijpen wát
Zonder monitoring ontdekt een bedrijf pas dat de website niet werkt wanneer een klant belt. Dat is reactief beheer: problemen worden dan pas zichtbaar nadat gebruikers er last van hebben gehad, waardoor herstel vaak urgenter en duurder uitpakt dan nodig was. Monitoring probeert problemen eerder zichtbaar te maken: een site die niet reageert, een stijgend foutpercentage, een database die tegen een limiet aanloopt, een falende API-call of een responstijd die oploopt.
Monitoring en logging worden vaak door elkaar gehaald terwijl ze verschillende vragen beantwoorden. Monitoring zegt dát het foutpercentage is gestegen; logging verklaart dat requests naar een specifieke betaalprovider timeouts geven. Die combinatie maakt een probleem oplosbaar in plaats van alleen zichtbaar. Daar hoort alerting bij, want een dashboard dat niemand bekijkt lost niets op: een kritieke fout moet leiden tot een melding bij iemand die kan handelen. Een goed alertbeleid vermijdt twee uitersten — alles melden wordt ruis waar mensen doorheen leren kijken, niets melden betekent dat storingen alsnog ongemerkt blijven.
Bij systemen met belangrijke beheerdersacties komt daar een audit trail bij, die achteraf laat reconstrueren wie wat wanneer deed: een gebruiker verwijderd, een orderstatus aangepast, rechten gewijzigd, configuratie veranderd. Dat is iets anders dan algemene applicatielogs. Error tracking vult het geheel aan door exceptions automatisch te verzamelen en te groeperen, zodat je het verschil ziet tussen één incidentele fout en dezelfde fout die driehonderd gebruikers raakt.
Bij dit alles past één nuance: monitoring voorkomt geen incidenten. Het helpt ze sneller te ontdekken, te begrijpen en op te lossen. Betrouwbaarheid komt uit de combinatie van een degelijk ontwerp, tests, observability en herstelprocedures — niet uit tooling alleen, en alleen als er iemand verantwoordelijk is voor de opvolging.
Externe diensten zijn onderdeel van je onderhoudsrisico
Veel digitale producten leunen op derden: een betaalprovider, CRM, maildienst, kaartendienst, authenticatieprovider, analytics of boekhoudsoftware. Verandert zo'n dienst, dan verandert jouw product mee, of het nu uitkomt of niet. Een leverancier kan een endpoint wijzigen, een oude API-versie uitfaseren, de authenticatie aanpassen of rate limits veranderen. Iemand moet die documentatie volgen, de integratie testen en op tijd migreren. Een API-koppeling is daarmee zelden een eenmalig project.
Ook de infrastructuur beweegt mee met het gebruik. Een database die bij livegang klein is, kan jaren later fors zijn gegroeid, met gevolgen voor performance, backups, query's, opslagkosten en migraties. Niet ieder product hoeft actief geschaald te worden, maar je wilt wel weten wat de huidige belasting is, waar de grenzen van de infrastructuur liggen en wat er gebeurt bij groei. Voor een eenvoudige bedrijfswebsite is managed hosting doorgaans genoeg; een drukke webapp vraagt aanvullende monitoring en een expliciete schaalstrategie.
Veilig wijzigen: omgevingen, releases en migraties
Onderhoud gaat niet alleen over productie. Nieuwe updates moeten ergens veilig getest kunnen worden, en daarvoor worden meestal aparte omgevingen gebruikt: development om te bouwen, een staging- of previewomgeving om wijzigingen in realistischer context te controleren, en productie met echte gebruikers en echte data. Niet ieder klein project heeft drie zware permanente omgevingen nodig, maar productie gebruiken als testomgeving vergroot het risico aanzienlijk.
CI/CD klinkt technisch, maar het zakelijke voordeel is eenvoudig: wijzigingen doorlopen steeds dezelfde gecontroleerde stappen, van codewijziging via automatische checks en tests naar build en deployment. Dat vermindert handmatig werk en daarmee vergissingen. Het maakt releases alleen niet vanzelf veilig — de kwaliteit hangt af van welke tests er draaien, hoe het reviewproces werkt en of er een rollback bestaat.
Die rollback is het onderdeel dat het vaakst ontbreekt. Een release kan ondanks tests fout gaan, dus moet duidelijk zijn wat er dan gebeurt. Terug naar de vorige versie klinkt eenvoudig, maar wordt complexer zodra er tegelijk databasewijzigingen zijn uitgevoerd. Een software-update die ook het datamodel verandert — een kolom toevoegen, een type wijzigen, data converteren — moet gecontroleerd gebeuren en bij voorkeur eerst buiten productie zijn getest, want een slechte migratie veroorzaakt downtime, dataverlies of inconsistentie die je niet met een rollback wegpoetst.
Tests horen in dit rijtje thuis omdat ze niet alleen voor de bouwfase bestaan; ze beschermen juist latere wijzigingen. Een goede teststrategie richt zich op de kritieke flows: inloggen, een order plaatsen, betalen en bevestigen, of een aanvraag laten goedkeuren waarna de status verandert en een notificatie uitgaat. Honderden tests hebben weinig waarde als ze de belangrijke risico's niet raken. Documentatie verdient dezelfde behandeling: een systeem kan goed gedocumenteerd starten en jaren later alsnog onbegrijpelijk zijn als niemand de architectuur, deploymentstappen, externe diensten en herstelprocedure heeft bijgewerkt.
Wie doet wat, en wat staat er in de afspraak
Een onderhoudsproces zonder eigenaar werkt niet. Voor ieder onderdeel moet duidelijk zijn wie reageert, en die verdeling verschilt per organisatie. Hosting ligt bij de leverancier of bij interne IT, applicatie-updates en monitoring meestal bij de ontwikkelpartner, het domein en de content bij de opdrachtgever, backups bij de hostingpartij met verificatie door de beheerder, en third-party accounts vaak in gedeeld beheer. Welke verdeling je ook kiest, ze moet expliciet zijn, want de onderdelen die tussen wal en schip vallen zijn precies de onderdelen die niemand bijhoudt.
Daarbij hoort het onderscheid tussen reactief en proactief werken. Reactief betekent dat iets stukgaat, een klant het meldt en het probleem daarna wordt opgelost. Proactief betekent updates volgen, monitoring controleren, backups testen en dependencies onderhouden, zodat problemen worden voorkomen of vroeg gedetecteerd. Beide blijven nodig, want ook met uitstekend proactief beheer komen incidenten voor. Maar uitsluitend reactief werken betekent dat problemen standaard pas zichtbaar worden nadat gebruikers er last van hebben gehad.
Een goede onderhoudsafspraak maakt dat concreet in plaats van het "volledige technische ondersteuning" te noemen. De vragen die daarin beantwoord horen te worden zijn niet ingewikkeld, en ze sluiten aan op het bredere kader uit hoe je de technische kwaliteit van een website of webapp beoordeelt:
- Wie controleert nieuwe versies, en wat gebeurt er bij een securityupdate?
- Wat wordt geback-upt, hoe lang bewaard, waar opgeslagen, en wanneer is restore voor het laatst getest?
- Wat wordt gemonitord, wie ontvangt kritieke alerts, en wat gebeurt er daarna?
- Wie beheert accounts en credentials, en hoe worden oude toegangen ingetrokken?
- Is duidelijk hoe een andere partij het systeem kan overnemen, en is de documentatie actueel?
Een SLA is daarbij iets anders dan een onderhoudsproces. Een SLA beschrijft serviceniveaus: responstijd, prioriteiten, beschikbaarheid. Onderhoud gaat breder over het technisch gezond houden van het product. Je kunt een onderhoudsovereenkomst hebben zonder zware SLA, en een snelle responstijd zegt op zichzelf niets over hoe proactief dependencies of backups worden beheerd.
Wat onderhoud kost, en waarom dat per product verschilt
Een universeel percentage van de bouwsom is hier weinig betrouwbaar. De werkelijke onderhoudslast hangt af van het aantal dependencies, de complexiteit, het aantal integraties, het datavolume, het securityrisico, het gewenste supportniveau, de monitoring en de hosting. Een eenvoudige site kan zeer weinig actief beheer vragen; een bedrijfskritische webapp vraagt structurele technische aandacht. Het is daarom nuttiger om onderhoud op activiteiten en risico's te begroten dan op een willekeurig percentage van de bouwsom, net zoals bij wat een website of webshop kost.
Die rekensom loopt bovendien twee kanten op. Een lage initiële bouwprijs zegt niets over de lifecyclekosten: is een product moeilijk te updaten, heeft het geen tests, is het sterk gekoppeld of slecht gedocumenteerd, dan wordt iedere toekomstige wijziging duurder. Tegelijk kan over-engineering het beheer net zo duur maken. Een kleine interne tool die is opgezet met meerdere microservices, complexe orchestration en een zware monitoringstack, levert vooral infrastructuur op die onderhouden moet worden zonder dat er zakelijke waarde tegenover staat. De beste oplossing is niet de maximaal technische, maar de passende.
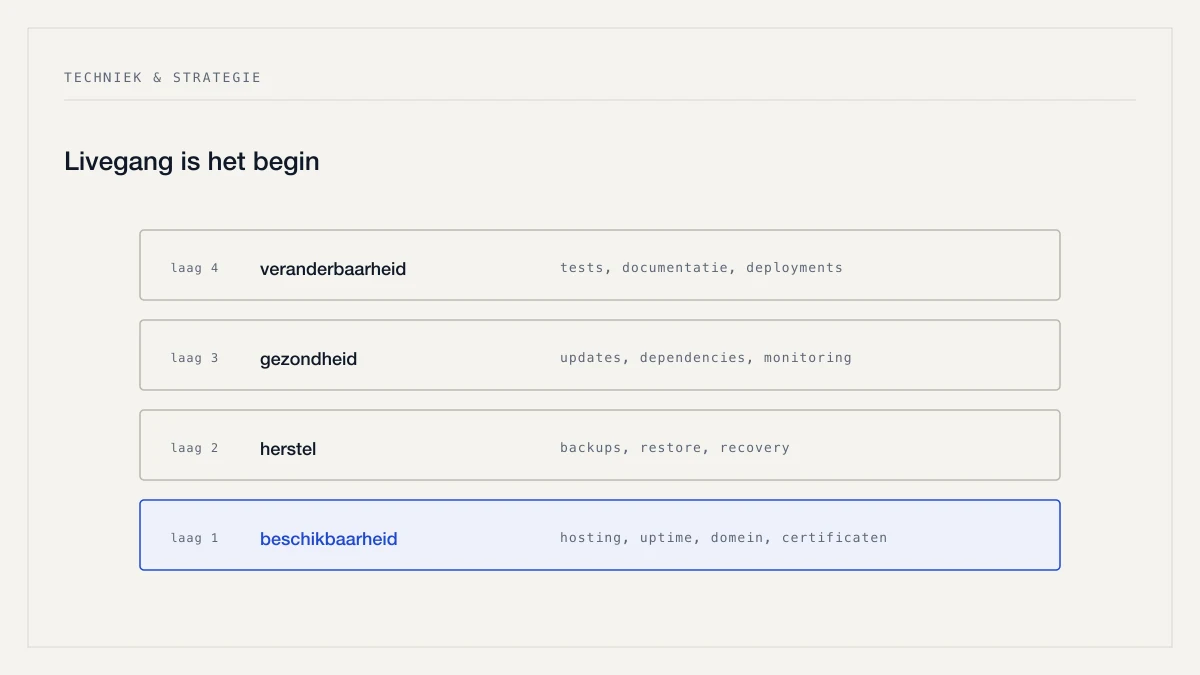
Voor veel zakelijke producten laat onderhoud zich ordenen in vier lagen die van onder naar boven zwaarder worden. Beschikbaarheid gaat over hosting, uptime, domein en certificaten. Herstel over backups, restore en een recoveryprocedure. Gezondheid over updates, dependencies, security en monitoring. Veranderbaarheid over tests, documentatie en gecontroleerde deployments. Hoe kritischer het product, hoe belangrijker alle vier worden — en hoe duidelijker zichtbaar wordt dat de bovenste laag zonder de onderste weinig waard is.
Wanneer is een product goed onderhouden?
Niet wanneer er nooit een bug ontstaat; dat is geen realistisch criterium. Een beter criterium is dat problemen vroeg zichtbaar worden, dat updates gecontroleerd kunnen worden uitgevoerd en dat herstel is voorbereid. Een onderhoudbaar product kan veranderen zonder dat iedere wijziging spannend wordt, een betrouwbaar product kan herstellen als er toch iets misgaat, en een professioneel beheerproces maakt duidelijk wie voor beide verantwoordelijk is.
De softwarewereld blijft bewegen nadat een website of webapp online staat. Een professioneel digitaal product houdt daarom vanaf het begin rekening met zijn eigen levenscyclus — niet door alles overdreven zwaar te maken, maar door vooraf te kunnen beantwoorden hoe er wordt geüpdatet, gemonitord en hersteld, wie er reageert en hoe overdracht verloopt. Ontbreken die antwoorden, dan is het product technisch misschien opgeleverd maar operationeel nog niet volwassen. Voor sites en applicaties die al draaien hoort dat werk bij redesign en optimalisatie.
Achterstallig onderhoud maakt toekomstige wijzigingen bovendien stelselmatig duurder; dat mechanisme staat uitgewerkt in technische schuld in software. En wil je weten welke assets en accounts je nodig hebt om niet volledig afhankelijk te worden van één leverancier, dan gaat van wie je website, code, data en accounts zijn daar verder op in.
Bronnen
Dit artikel is opgesteld op basis van het onderzoeksdossier Digitale techniek & strategie voor zakelijke websites, webapps en digitale producten.
Belangrijkste bronnen en broncategorieën uit het dossier:
- IBM — backup versus disaster recovery
- bronnen over RPO en RTO
- IBM — logging en monitoring
- Google Cloud — secret management en credential rotation
- NIST en OWASP — securityprincipes
- officiële en technische documentatie rond dependencybeheer
- bronnen over CI/CD, veilige deployments en databasemigraties
- software-engineeringbronnen over documentatie en lifecyclekosten
Het dossier benadrukt dat onderhoudskosten sterk afhangen van architectuur, risico, infrastructuur en externe afhankelijkheden. Daarom is bewust geen universeel onderhoudspercentage of vaste marktprijs genoemd.