
Hoe beoordeel je de technische kwaliteit van een website of webapp?
Technische kwaliteit zie je niet alleen aan snelheid of een nette interface. Onderhoudbaarheid, architectuur, data-integriteit, security, tests, observability, herstelbaarheid en documentatie bepalen of een website of webapp ook op lange termijn gezond blijft.
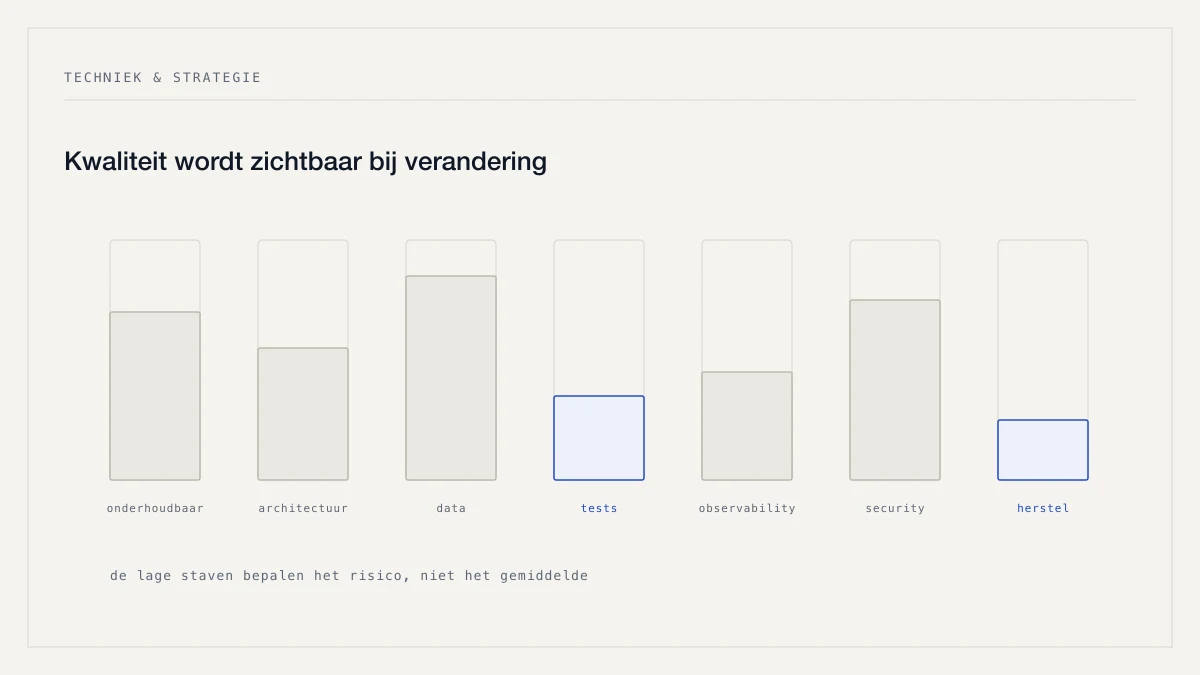
Een digitale oplossing kan er professioneel uitzien en technisch toch kwetsbaar zijn. De homepage laadt, het dashboard werkt, formulieren sturen gegevens door — op het eerste gezicht lijkt alles in orde. Technische kwaliteit wordt pas zichtbaar op het moment dat er iets verandert: wanneer er een functie bij moet, een externe API wijzigt, een developer vertrekt, een security-update nodig is, het aantal gebruikers groeit, een database gemigreerd moet worden of een incident hersteld moet worden. Dan blijkt of het systeem begrijpelijk, onderhoudbaar en herstelbaar is.
Dat maakt technische kwaliteit lastig te beoordelen voor een opdrachtgever. Je kunt de code meestal niet zelf lezen, en zelfs met toegang zegt een nette repository nog weinig over de architectuur. De bruikbare vraag is daarom niet of een website technisch goed gebouwd is, maar welke eigenschappen het product veilig veranderbaar, betrouwbaar in gebruik en overdraagbaar op lange termijn maken. Onderhoudbaarheid, een begrijpelijke architectuur, modulariteit, data-integriteit, testbaarheid, observability, security, herstelbaarheid en documentatie vertellen samen veel meer dan een losse Lighthouse-score of de gebruikte programmeertaal.
Technische kwaliteit is meer dan snelheid
Snelheid telt, maar een snelle website kan alsnog moeilijk te onderhouden zijn, en een degelijk opgebouwde webapp kan tijdelijk een performanceprobleem hebben dat gericht op te lossen is. Kwaliteit bestaat uit meerdere dimensies, en een bruikbare manier om ernaar te kijken is via vijf vragen: kan het systeem veilig veranderen, kan het fouten opvangen, blijft de data betrouwbaar, kunnen problemen worden gevonden, en kan een andere partij het begrijpen? Is het antwoord op meerdere van die vragen nee, dan bestaat er technisch risico — ongeacht hoe de site eruitziet.
Onderhoudbaarheid, architectuur en modulariteit
Onderhoudbaarheid gaat over hoe makkelijk een systeem kan worden aangepast, gerepareerd of uitgebreid. Dat klinkt abstract, maar de zakelijke gevolgen zijn heel concreet: bij goede onderhoudbaarheid blijft een wijziging relatief lokaal, bij slechte onderhoudbaarheid raakt één kleine aanpassing allerlei andere onderdelen. Signalen van een onderhoudbaar systeem zijn duidelijke verantwoordelijkheden per onderdeel, weinig onnodige duplicatie, een begrijpelijke structuur, voorspelbare interfaces, tests rond kritieke logica en dependencies die actief worden beheerd.
Je hoeft daarvoor geen code te lezen; je kunt naar gedrag kijken. Leidt een kleine wijziging tot beperkt ontwikkelwerk en een voorspelbare testscope, of tot veel onverwachte gevolgen en steeds extra herstelwerk? Dat verschil vertelt in de praktijk meer dan welke technische verklaring dan ook.
Architectuur hoeft daarbij niet simpel te zijn, wel begrijpelijk. Een goede architectuur maakt duidelijk welke onderdelen er bestaan, welke verantwoordelijkheid elk onderdeel heeft, hoe data stroomt, waar de businessregels zitten en welke externe diensten worden gebruikt. Voor een kleine site hoeft daar geen dik document over te bestaan, maar bij een serieuze webapp is het waardevol als een nieuwe developer de route van frontend via API en database naar de externe systemen kan volgen en per component begrijpt waarvoor die dient. Architectuurdocumentatie bestaat om kennis te borgen, niet om te bestaan.
Modulariteit betekent dat onderdelen logisch gescheiden zijn — authenticatie, orders, facturatie en notificaties als herkenbare domeinen. Het doel is niet dat ieder domein een aparte service wordt; ook een monolithische applicatie kan uitstekend modulair zijn. Hangen modules weinig onnodig van elkaar af, dan blijft een wijziging vaker beperkt tot één deel, wat de testimpact, de foutkans en de onderhoudskosten verlaagt. Microservices worden soms verkocht als automatisch modern of schaalbaar, maar een kleine applicatie met tien losse services is operationeel vaak ingewikkelder dan één goed gestructureerde applicatie. Modulair en microservices zijn niet hetzelfde: het gaat om duidelijke grenzen, niet om zoveel mogelijk losse deployments.
Data-integriteit is bedrijfskritisch
Een digitaal product is alleen betrouwbaar als de data klopt. Gegevens mogen niet zomaar verdwijnen, niet tegenstrijdig worden, niet ongeautoriseerd wijzigen en moeten valide blijven. Concreet betekent dat dat een order niet half opgeslagen mag worden, een betaling niet dubbel verwerkt, een klantrecord zijn relaties consistent houdt en een statuswijziging correct wordt vastgelegd.
Het verschil in ernst is groot. Een interfacefout is vervelend; een fout in financiële of klantdata werkt door in facturen, voorraden en klantrelaties, en is achteraf vaak moeilijk te herstellen. Daarom hoort technische kwaliteit ook beoordeeld te worden op het datamodel, het gebruik van transacties, validatie, migraties en herstelmogelijkheden. Een spreadsheet die een bedrijfsproces is gaan dragen laat goed zien wat er misgaat wanneer die structuur ontbreekt; zie van Excel en workarounds naar software.
Testbaarheid, observability en monitoring
Een systeem dat makkelijk te testen is, kan doorgaans veiliger worden aangepast — niet omdat tests alle bugs voorkomen, maar omdat regressies sneller zichtbaar worden. Er bestaan verschillende testlagen, van unit tests en integratietests tot end-to-end tests, acceptatietests en security- en reliabilitychecks, en elk daarvan heeft een ander doel. Niet alles hoeft even zwaar getest: een marketingpagina vraagt een andere strategie dan een webapp met rollen, betalingen, workflows en externe integraties. De testinspanning hoort te volgen uit risico. Waar dat risico hoog is — inloggen, een order aanmaken, een betaling verwerken en bevestigen, of een manager die een aanvraag goedkeurt waarna de status verandert en een notificatie uitgaat — is het logisch dat die flows expliciet zijn afgedekt.
Observability betekent dat je genoeg signalen hebt om te begrijpen wat er in het systeem gebeurt, doorgaans via metrics, logs en tracing. Voor een opdrachtgever hoeft die term niet ingewikkeld te zijn; de praktische vraag is of je bij een storing kunt vinden waar en waarom het misgaat. Melden gebruikers dat de checkout soms niet werkt en ontbreken logging en fouttracking, dan kan een ontwikkelaar nauwelijks zien welk verzoek faalde, bij welke gebruiker, welke externe dienst erbij betrokken was en welke foutcode terugkwam. Debuggen wordt dan duur en traag.
Monitoring is daarvan het actieve broertje: uptime, foutpercentage, responstijd en resourcegebruik worden gevolgd, en alerting bepaalt wanneer iemand moet handelen. Een professioneel systeem heeft daarom niet alleen data maar ook een proces — een signaal leidt tot een melding, die bij een verantwoordelijke terechtkomt, die vervolgens iets doet.
Security, tenantisolatie en secrets
Security is geen checklist voor na livegang maar onderdeel van technische kwaliteit. Het gaat om authenticatie, autorisatie, least privilege, inputvalidatie, rate limiting, secret management, dependency security en veilige sessies. Het belangrijkste onderscheid daarbinnen is dat tussen authenticatie en autorisatie: het eerste beantwoordt wie je bent, het tweede wat je mag. Een applicatie kan uitstekend inloggen en toch onveilig zijn wanneer de autorisatie zwak is, bijvoorbeeld wanneer een gebruiker via een aangepast verzoek data van een andere organisatie kan opvragen. Rechten horen daarom server-side te worden afgedwongen, niet door knoppen te verbergen.
Bij multi-tenant software, waarbij meerdere klanten dezelfde applicatie delen, geldt één regel onvoorwaardelijk: de ene tenant mag nooit data van de andere zien. Dat moet technisch worden afgedwongen en niet doordat de interface bepaalde onderdelen niet toont. Hoe dat is geregeld, zegt veel over de technische volwassenheid van een product.
Secrets vormen het derde punt. API-keys, databasewachtwoorden en vergelijkbare gegevens horen niet in frontendcode, niet in een publieke repository, niet in losse chatberichten en niet in logs. Een professioneel systeem heeft een duidelijke manier om credentials te beheren, bijvoorbeeld met een secret manager, afgeschermde environmentconfiguratie, beperkte productietoegang en rotatie. Voor de opdrachtgever is vooral van belang dat die secrets niet aan één persoon vastzitten.
Dependencies, herstelbaarheid en externe diensten
Moderne software gebruikt libraries, en dat is normaal. Kwaliteit zit niet in zo min mogelijk dependencies maar in bewuste selectie, versiebeheer, updates, securityscans en het bewaken van end-of-life. Een verouderde stack is niet automatisch slecht, maar een stack die niet meer wordt onderhouden levert wel problemen op: securitypatches stoppen, andere libraries worden incompatibel en hostingondersteuning verdwijnt. Lifecyclebeheer hoort daarom bij de beoordeling.
Herstelbaarheid is het punt waar veel beoordelingen te oppervlakkig blijven. Een betrouwbaar systeem is niet een systeem dat nooit faalt — dat bestaat praktisch niet — maar een systeem dat is voorbereid op herstel, met backups, restoreprocedures, rollback, waar nodig failover en incidentdocumentatie. Een databasebackup kan bestaan terwijl niemand ooit heeft getest of hij bruikbaar kan worden teruggezet; dan blijft herstel een aanname. Voor kritieke systemen is een periodieke restoretest daarom informatiever dan de mededeling dat backups dagelijks draaien.
Externe diensten horen bij diezelfde categorie. Een product leunt vaak op een CRM, betaalprovider, maildienst, kaartendienst, AI-service of boekhoudsoftware, en die calls kunnen tijdelijk mislukken. Patronen als timeouts, retries, idempotency en graceful degradation bepalen wat er dan gebeurt. Idempotency is daarbij het belangrijkst: is een betaling uitgevoerd maar komt het antwoord niet aan, dan probeert de applicatie het opnieuw — en is die operatie niet veilig herhaalbaar, dan vindt dezelfde betaling twee keer plaats. Betrouwbaarheid zit vaak precies in dit soort randgevallen.
Schaalbaarheid, over-engineering en de weg naar productie
"Schaalbaar" is een van de meest misbruikte woorden in digitale projecten, omdat het zinloos is zonder te zeggen wát er moet schalen. Dat kan gaan om gebruikers, organisaties, data, bestanden, workflows, rollen, integraties, verkeer of zelfs de omvang van het ontwikkelteam. Een applicatie kan op de ene as uitstekend schalen en op de andere vastlopen: een platform dat miljoenen pageviews aankan, kan moeite hebben met duizenden organisaties, complexe permissies of zeer grote bestanden. "Gebouwd voor schaal" is daarom geen bruikbare claim zonder concrete context.
Aan de andere kant hoort bij technische kwaliteit ook weten wat je níét moet bouwen. Vroeg complexiteit toevoegen voor hypothetische toekomstige schaal — een klein intern systeem met microservices, een eventbus, meerdere databases en zware orchestration — levert vooral deployment, monitoring, security, foutscenario's, documentatie en onderhoud op zonder navenante waarde. Kwaliteit is balans, niet maximale complexiteit.
Hoe wijzigingen naar productie gaan, zegt eveneens veel. In zakelijke software bestaan doorgaans aparte omgevingen: development om te bouwen, staging of preview voor realistische tests en acceptatie, en productie voor echte gebruikers en echte data. Niet ieder klein project heeft drie zware permanente omgevingen nodig, maar direct experimenteren op productie is een risico. CI/CD helpt om wijzigingen herhaalbaar te controleren en uit te rollen, van code via build, tests en checks naar deployment, en vermindert handmatige stappen. Het is alleen geen kwaliteitsbewijs op zichzelf: een pipeline zonder zinvolle tests automatiseert vooral slechte controle. Databasemigraties verdienen daarbij aparte aandacht, omdat een nieuwe softwareversie soms ook het datamodel verandert. Backward compatibility, dataconversie, testbaarheid en rollback horen dan bij de releasekwaliteit, want een slechte migratie veroorzaakt downtime of dataproblemen ook wanneer de applicatiecode perfect is.
Documentatie en overdraagbaarheid
De beste documentatie is niet de langste maar die welke iemand helpt een concreet probleem op te lossen: een architectuuroverzicht, het datamodel, deploymentinstructies, API-contracten, de belangrijkste businessregels en een runbook. De scherpste toets daarvoor is een continuïteitsvraag: als de belangrijkste ontwikkelaar morgen vertrekt, kan een andere competente developer het systeem dan begrijpen en beheren? Is het antwoord nee, dan bestaat er persoonsafhankelijkheid — en dat is een bedrijfsrisico, geen technisch detail.
Technische kwaliteit stopt daarmee niet bij de code. Een professioneel digitaal product moet ook beheerbaar blijven als de leverancier verandert, wat repositorytoegang, data-export, domein, hosting, accounts, credentials en documentatie relevant maakt. Een technisch knap systeem dat niet over te dragen is, vormt een serieus continuïteitsrisico; van wie je website, code, data en accounts zijn werkt dat per onderdeel uit.
Een audit zonder zelf developer te zijn
Je kunt veel beoordelen zonder één regel code te lezen, mits je om bewijs vraagt in plaats van om geruststelling. Vraag niet of iets schaalbaar is, maar welke schaalproblemen zijn voorzien en hoe die zijn opgelost. Vraag niet of het veilig is, maar hoe rechten server-side worden afgedwongen en hoe dependencies worden bijgehouden. Vraag niet of er backups zijn, maar wanneer de laatste restore is getest. Concreet bewijs is waardevoller dan een slogan.
De onderwerpen die daarbij horen zijn goed af te bakenen:
- Architectuur — is er een begrijpelijk overzicht van componenten, waar zitten de businessregels, en welke externe systemen zijn afhankelijkheden?
- Data — wat is de source of truth, hoe wordt integriteit afgedwongen, en hoe verlopen databasemigraties?
- Security — hoe zijn authenticatie en autorisatie ingericht, hoe worden secrets beheerd, en hoe worden dependencies gescand en bijgewerkt?
- Testing — welke kritieke flows zijn geautomatiseerd getest, wat draait er vóór deployment, en hoe wordt regressie voorkomen?
- Operations en recovery — welke monitoring en alerts bestaan er, hoe worden incidenten opgevolgd, welke backups zijn er, wanneer is restore getest en hoe werkt rollback?
- Continuïteit — wie heeft repositorytoegang, wie beheert hosting en domeinen, en is er voldoende documentatie voor overdracht?
Geen enkel signaal bewijst op zichzelf dat een systeem slecht is, maar combinaties zijn veelzeggend. Geen tests, geen monitoring, geen documentatie, één persoon met productiecredentials, updates die al jaren worden uitgesteld en deployment die handmatig en ongedocumenteerd gebeurt: dat is samen een veel sterker risicosignaal dan één verouderde library.
Wees daarbij alert op technische marketingtermen. Woorden als enterprise-grade, cloud-native, future-proof, scalable en secure by default klinken professioneel maar zijn zonder bewijs slechts labels. Een sterke leverancier kan uitleggen wat er technisch is gedaan en waarom. Niet "volledig schaalbaar platform", maar bijvoorbeeld: de applicatie draait stateless, bestanden staan buiten de applicatieserver en de database is het huidige schaalpunt, wat bij het verwachte volume ruim voldoende is. Dat laatste is toetsbaar.
Kwaliteit moet passen bij het bedrijfsrisico
Een eenvoudige campagnewebsite stelt andere eisen dan een platform waarop dagelijks orders, persoonsgegevens en financiële transacties lopen. "Best practice" is daarom nooit volledig contextloos. Wat telt is de impact van uitval, de gevoeligheid van de data, de veranderfrequentie, het aantal gebruikers, de afhankelijkheden en de verwachte levensduur. Hoe hoger het risico, hoe meer technische discipline logisch wordt. Diezelfde afweging bepaalt een groot deel van de scope in wat een website of webshop kost.
Over-engineering is in dat licht evengoed een kwaliteitsprobleem. Meer infrastructuur dan de organisatie nodig heeft, leidt tot hogere hostingkosten, complexere deployments, grotere kennisafhankelijkheid en moeizamer foutzoeken. De technisch volwassen conclusie is soms dat een probleem nu niet groot genoeg is om extra infrastructuur te rechtvaardigen. Dat is geen gebrek aan ambitie maar architectuurdiscipline.
Een audit die eindigt met een rood-groen rapport is daarom minder waard dan een audit die prioriteert. Een autorisatielek, ontbrekende backups of een end-of-life dependency vragen om directe actie. Testdekking rond een kritieke workflow, documentatie van deployment en een dependency-upgrade kunnen binnen afzienbare tijd. Een oudere maar ondersteunde library en wat duplicatie in een weinig gebruikte module mag je accepteren. Zo wordt technische kwaliteit een zakelijke risicobeslissing in plaats van een schoonheidswedstrijd tussen developers.
Kwaliteit wordt zichtbaar bij verandering
Een digitale oplossing is niet goed omdat hij vandaag werkt. Hij is technisch gezond wanneer hij morgen gewijzigd kan worden, veilig kan worden geüpdatet, problemen zichtbaar maakt, data beschermt, kan herstellen na fouten en door een andere partij begrepen kan worden. Dat is waar technische kwaliteit waarde krijgt — niet in het aantal frameworks, niet in het aantal microservices en niet in de bewering dat iets future-proof is.
De sterkste technische basis is een systeem dat past bij het huidige bedrijfsprobleem, voldoende ruimte laat voor realistische groei en zonder onnodige complexiteit beheersbaar blijft. Voor een site of applicatie die al draait, begint dat meestal bij redesign en optimalisatie.
Hoe verkeerde technische keuzes zich door de tijd opstapelen, staat in technische schuld in software. En welk beheerwerk er na oplevering bij komt kijken, beschrijft wat er na livegang gebeurt.
Bronnen
Dit artikel is opgesteld op basis van het onderzoeksdossier Digitale techniek & strategie voor zakelijke websites, webapps en digitale producten.
Belangrijkste bronnen en broncategorieën uit het dossier:
- CISQ — onderhoudbaarheid van software
- Microsoft — design for testability
- NIST — data-integriteit en least privilege
- OWASP — veilige softwareontwikkeling en veelvoorkomende beveiligingsrisico's
- IBM — observability, logging en monitoring
- Google Cloud — secret management
- technische bronnen rond CI/CD en databasemigraties
- software-engineeringbronnen over architectuurdocumentatie, modulariteit en over-engineering
De technische principes uit deze bronnen zijn in dit artikel vertaald naar een besliskader voor opdrachtgevers en zakelijke beslissers, niet naar een programmeertutorial.