
Welke bedrijfsprocessen moet je automatiseren — en welke juist niet?
Niet ieder repetitief proces is een goede automatiseringskandidaat. Leer welke signalen wijzen op echte automatiseringskansen en wanneer je beter eerst het proces zelf verbetert.
Automatisering begint doorgaans met een herkenbare frustratie. Iemand voert dezelfde gegevens opnieuw in, kopieert informatie tussen systemen of stuurt voor de zoveelste keer dezelfde statusmail. Dat zijn bruikbare signalen, maar ze betekenen nog niet dat het proces ook een goede kandidaat is.
Een taak kan namelijk heel repetitief zijn en tegelijk te risicovol, te veranderlijk of te vol uitzonderingen om verstandig te automatiseren. Andersom kan een proces dat maar één keer per week voorkomt veel opleveren wanneer het nu veel tijd kost of andere mensen laat wachten. De vraag is daarom niet welke taken repetitief zijn, maar welke processen stabiel, waardevol en controleerbaar genoeg zijn om betrouwbaar automatisch te laten verlopen. Dat onderscheid voorkomt de klassieke uitkomst: een inefficiënt proces dat voortaan sneller inefficiënt is.
Automatisering bestaat op verschillende niveaus
Het woord automatisering dekt in de praktijk een reeks van heel verschillende ingrepen, en het helpt om die uit elkaar te houden voordat je iets laat bouwen.
Het lichtste niveau is taakautomatisering: één terugkerende handeling die automatisch gebeurt, bijvoorbeeld een ontvangstbevestiging die uitgaat zodra een formulier binnenkomt. Dat kan nuttig zijn, maar het lost nog geen procesketen op. Een stap verder gaat workflowautomatisering, waarbij meerdere stappen elkaar in een vaste volgorde opvolgen — een aanvraag wordt gevalideerd, aan een medewerker toegewezen, omgezet in een taak en bevestigd naar de klant. Vanaf dat moment moeten uitzonderingen expliciet worden afgehandeld, want de flow loopt door zonder dat iemand meekijkt.
Weer een niveau hoger zit systeemintegratie, waarbij twee of meer systemen onderdeel worden van dezelfde datastroom, bijvoorbeeld van website naar CRM naar administratie. Daar wordt de vraag wie eigenaar is van welke data plotseling doorslaggevend. Een API-koppeling is in dat geheel geen zelfstandig bedrijfsdoel maar één technische manier om zo'n integratie te realiseren.
AI verdient in dit rijtje een aparte plaats. Het is bruikbaar wanneer de input ongestructureerd is: een inkomende e-mail classificeren, gegevens uit een document halen, een klantbericht samenvatten of een routingvoorstel doen. Daarmee is AI één mogelijke component binnen een proces, en niet een synoniem voor automatisering zelf.
Waar de eerste kansen meestal zitten
Een sterke kandidaat herken je zelden aan één kenmerk; het zijn meestal meerdere signalen tegelijk.
Het duidelijkste signaal is dat dezelfde gegevens opnieuw worden ingevoerd. Een aanvraag komt binnen via een websiteformulier, een medewerker leest hem en typt de gegevens over in het CRM. Die medewerker fungeert dan feitelijk als handmatige integratielaag. Is de brondata duidelijk en biedt het CRM een betrouwbare interface, dan is dit een logisch vertrekpunt. Hetzelfde geldt voor het kopiëren tussen applicaties: een ordernummer van de webshop naar de boekhouding, klantgegevens van het CRM naar een portaal, voorraadgegevens van het ERP naar de webshop, projectgegevens van de intake naar de offerte. Hoe vaker hetzelfde gegeven met de hand ergens anders terechtkomt, hoe groter de kans op afwijkende versies en herstelwerk.
Een tweede signaal is dat spreadsheets of e-mail het proces zijn gaan dragen. Excel is niet vanzelf een probleem, maar wanneer een proces alleen werkt doordat bestanden voortdurend worden doorgestuurd, gekopieerd en aangepast, zijn status en eigenaarschap verspreid geraakt. Een planningsbestand dat per mail rondgaat, waar iedereen zijn eigen versie van aanpast en terugstuurt, is daar het klassieke voorbeeld van. Automatisering kan dan interessant zijn, maar pas nadat duidelijk is welke versie leidend hoort te zijn. Wanneer een spreadsheet het proces volledig is gaan dragen, gaat het eerder over Excel vervangen door software dan over een koppeling.
Het derde signaal is dat het proces vaste regels volgt. Een aanvraag uit de ene regio gaat naar de ene accountmanager en uit de andere regio naar een andere; een order die op verzonden wordt gezet, leidt tot een transactionele e-mail. Hoe explicieter de beslisregels, hoe betrouwbaarder software ze kan uitvoeren. Formulieren zijn om die reden natuurlijke startpunten: één inzending kan een contact in het CRM aanmaken, een deal koppelen, een taak voor een medewerker genereren en een bevestiging versturen. Dat is interessanter dan alleen het formulier zelf sneller maken, omdat het hele vervolgproces onderdeel van dezelfde flow wordt.
Repetitief is niet hetzelfde als geschikt
Een veelgemaakte fout is automatisering uitsluitend op frequentie beoordelen. Een dagelijkse handeling kan te risicovol zijn om zonder menselijke controle te laten verlopen, terwijl een wekelijkse handeling juist veel kan opleveren wanneer ze veel tijd kost, ander werk blokkeert, foutgevoelig is of meerdere mensen bezighoudt. Frequentie is één factor in de afweging, niet het hele model.
Wanneer je beter niet automatiseert
Er zijn zeven situaties waarin automatiseren doorgaans te vroeg komt, en ze zijn het waard om vooraf langs te lopen.
De eerste is dat het proces nog niet stabiel is. Volgen medewerkers niet dezelfde werkwijze, dan is het te vroeg om die werkwijze in software vast te leggen — software automatiseert beslisregels, en staan die regels nog ter discussie, dan programmeer je die discussie in de workflow. Wanneer de ene medewerker een aanvraag anders beoordeelt dan de andere en een derde er eigen uitzonderingen bij maakt, is procesontwerp de eerste stap.
De tweede is dat uitzonderingen de norm zijn. Sommige processen lijken op papier voorspelbaar maar bestaan in de praktijk grotendeels uit afwijkingen. Vereist bijna iedere case menselijke interpretatie, dan kan automatisering nog steeds helpen bij de intake, de routing, het verzamelen van documenten en statusupdates, terwijl de eigenlijke beslissing bewust bij een mens blijft. Goede automatisering hoeft niet te betekenen dat een proces van begin tot eind zonder tussenkomst verloopt.
De derde is onbetrouwbare brondata. Automatisering verwerkt slechte data net zo efficiënt als goede. Zijn klantnamen inconsistent, worden orderstatussen handmatig bijgehouden, zijn productcodes niet uniek of bevatten meerdere systemen verschillende prijzen, dan verhelpt een koppeling het onderliggende probleem niet — die verspreidt het alleen sneller. De vierde, nauw verwante situatie is dat niemand weet welk systeem leidend is. Mogen zowel het CRM als de administratie een klantadres wijzigen, dan ontstaat bij iedere afwijking de vraag welke wijziging wint, en verandert tweerichtingssynchronisatie in conflictmanagement. Vaak is de betere opzet dat één systeem bron is voor contactgegevens en het andere die gegevens uitsluitend consumeert.
De vijfde situatie is dat volume en waarde te laag zijn. Een technisch elegante automatisering kan economisch zinloos zijn: kost een handmatige taak vijf minuten per maand, veroorzaakt hij nauwelijks fouten en heeft hij geen klantimpact, dan wegen ontwikkeling en onderhoud waarschijnlijk zwaarder dan de besparing. De zesde is dat een proceswijziging goedkoper is dan software. Kopieert een medewerker een veld omdat twee systemen hetzelfde gegeven vragen, dan zijn er drie routes: een koppeling bouwen, het tweede veld schrappen, of het proces zo aanpassen dat het gegeven nog maar één keer wordt vastgelegd. De tweede route is vaak veruit de beste, en de goedkoopste.
De zevende is dat de foutimpact hoog is terwijl controle ontbreekt. Rond facturatie, betalingen, voorraad, fulfillment en klantbeloftes kan een fout grote gevolgen hebben, en dan is volledig automatische verwerking zonder tussenkomst onverstandig. Een veiliger vorm is dat software het concept voorbereidt, een mens goedkeurt en het systeem daarna de definitieve verwerking doet. Automatiseren betekent dus niet dat elke menselijke controle moet verdwijnen.
Vier knock-outvragen
Voor een eerste beoordeling zijn vier vragen bijzonder bruikbaar, en een structureel "nee" op één ervan betekent meestal dat het procesontwerp voorgaat:
- Is de gewenste werkwijze duidelijk? Zijn medewerkers het grotendeels eens over hoe het proces hoort te lopen? Zo niet, ontwerp eerst het proces.
- Is het brongegeven aanwijsbaar? Weet je welk systeem eigenaar is van klant, order, prijs, status en factuur? Zo niet, bepaal eerst de source of truth.
- Is succes controleerbaar? Kan het systeem na afloop vaststellen dat de actie werkelijk is gelukt? Een API-call zonder verifieerbaar resultaat is geen betrouwbare processtap.
- Is er een herstelpad? Kan iemand bij een storing de fout terugvinden, zien welke records geraakt zijn, opnieuw uitvoeren en handmatig corrigeren? Zo niet, dan is de flow operationeel nog niet volwassen.
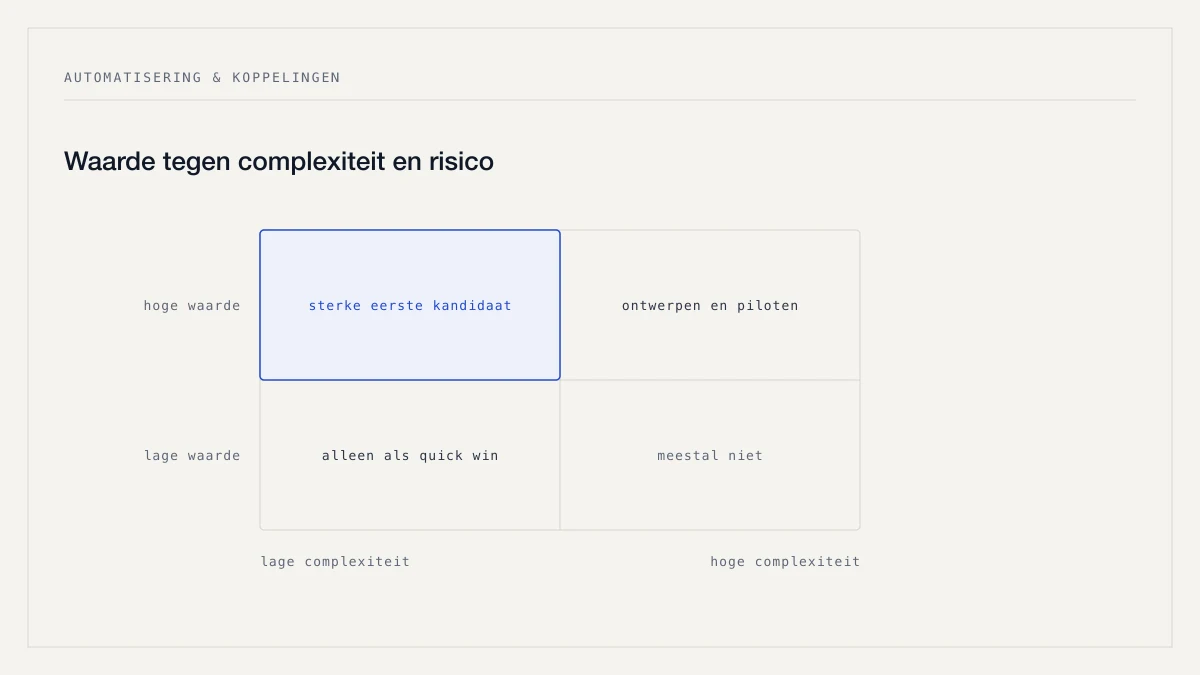
Waarde tegen complexiteit
Komt een proces door die vier vragen heen, dan kun je het op twee assen beoordelen. De waarde volgt uit de frequentie, de minuten per uitvoering, de foutimpact, de doorlooptijd, de zakelijke impact en het aantal betrokken medewerkers. De complexiteit en het risico volgen uit de voorspelbaarheid, het aantal uitzonderingen, de kwaliteit van de beschikbare API's, het aantal systemen, de privacy- en securityimpact, de eventuele noodzaak van tweerichtingssynchronisatie, de onderhoudslast en opnieuw de foutimpact.
Zet je die twee tegen elkaar af, dan ontstaat een eenvoudige heuristiek — geen industrienorm, maar wel een die in de praktijk goed werkt om te bepalen waar je begint.
| Waarde | Complexiteit / risico | Advies |
|---|---|---|
| Hoog | Laag | Sterke eerste kandidaat |
| Hoog | Hoog | Ontwerpen, piloten en businesscase uitwerken |
| Laag | Laag | Alleen meenemen als quick win |
| Laag | Hoog | Meestal niet automatiseren |
Drie processen naast elkaar
Het verschil tussen die kwadranten wordt concreet zodra je er echte processen naast legt.
Neem een websitelead die handmatig in het CRM belandt. De aanvraag komt in een mailbox, een medewerker leest hem, maakt een contact aan, koppelt er een deal aan, zet een taak klaar voor sales en stuurt een bevestiging. Dat is vaak een sterke kandidaat: de input is gestructureerd, het proces is herhaalbaar, de systemen kunnen duidelijke rollen krijgen, succes is controleerbaar en de handmatige overdracht kan grotendeels verdwijnen. De toekomstige flow valideert het formulier, geeft de aanvraag een eigen identificatie, zoekt het contact op in het CRM, maakt contact of bedrijf aan waar nodig, koppelt de deal, zet de taak klaar en verstuurt de bevestiging. De technische uitwerking daarvan staat in website koppelen aan CRM.
Daar staat een bedrijf tegenover dat complexe maatwerkoffertes maakt, waarbij iedere aanvraag inhoudelijke analyse, engineering, een commerciële afweging en overleg met specialisten vraagt. Het proces bevat zeker repetitieve stappen, maar de waarde zit in de menselijke beoordeling. Volledige automatisering is dan geen zinvol doel. Wat wél kan is de intake structureren, de benodigde documenten verzamelen, een dossier aanmaken, een taak toewijzen en de status bewaken — je automatiseert de voorspelbare randstappen en laat de expertise met rust.
Het derde voorbeeld laat zien waarom frequentie misleidend kan zijn. Een factuur genereren zodra een order binnenkomt gebeurt mogelijk dagelijks, en toch is directe automatisering riskant. Kunnen fouten leiden tot dubbele financiële records, dan moet de oplossing rekening houden met unieke identificatie, controleerbare verwerking, idempotency, herstel en logging. Dat maakt het technisch aanzienlijk complexer dan de frequentie doet vermoeden.
De waarde berekenen uit eigen cijfers
Begin bij je eigen proces in plaats van bij algemene rendementsclaims. Harde tijdwinst bereken je door de bespaarde minuten per uitvoering te vermenigvuldigen met het aantal uitvoeringen, het aantal perioden en het aantal betrokken medewerkers, en dat te delen door zestig. Bespaar je drie minuten per keer bij honderd uitvoeringen per week over achtenveertig werkweken, dan kom je op tweehonderdveertig uur per jaar. Dat is een rekenvoorbeeld en geen belofte: het zegt iets over de methode, niet over jouw organisatie.
Belangrijker is dat tijdwinst niet vanzelf kostenbesparing is. Vrijgekomen tijd krijgt pas economische waarde wanneer die ergens zinvol landt — minder overwerk, lagere externe administratiekosten, meer capaciteit zonder extra personeel, meer tijd voor commercieel werk of een kortere doorlooptijd. Blijft de bezetting gelijk en creëert de vrijgekomen tijd geen andere waarde, dan ziet de businesscase er wezenlijk anders uit.
Naast tijd zijn er meetbare effecten die vaak zwaarder wegen. Foutkosten benader je door het aantal aantoonbare fouten te vermenigvuldigen met de gemiddelde herstelkosten. Doorlooptijd meet je door de mediane tijd tussen ontvangst en verwerking voor en na de wijziging te vergelijken. Capaciteit gaat over de vraag of dezelfde bezetting meer aanvragen, orders of dossiers aankan. En herstelwerk is de tijd die nu verloren gaat aan ontbrekende gegevens, dubbele invoer, verkeerde statussen en handmatige correcties. Klantimpact is legitiem om mee te nemen, maar monetariseer die alleen wanneer je eigen gegevens dat ondersteunen; een percentage over hogere klanttevredenheid zonder onderbouwing voegt niets toe aan een businesscase.
Een praktische procesaudit
De snelste manier om hier grip op te krijgen is één bestaand proces letterlijk uitschrijven, stap voor stap, zoals het nu werkelijk verloopt: klant vult formulier in, medewerker leest de mail, opent het CRM, zoekt een bestaand contact, maakt een deal, maakt een taak, stuurt een bevestiging. Beantwoord vervolgens per stap een vaste set vragen:
- Welke data komt binnen, en waar komt die vandaan?
- Wie is eigenaar van dat gegeven?
- Welke beslissing wordt hier genomen, en is die voorspelbaar?
- Wat kan er misgaan, hoe ontdek je dat, en hoe herstel je het?
- Moet een mens goedkeuren?
- Kan deze stap misschien helemaal verdwijnen?
Die laatste vraag levert vaak de meeste winst op, en zelden staat het antwoord in een softwareofferte.
Automatiseren begint bij procesontwerp
De beste kandidaten delen dezelfde kenmerken: het proces is stabiel, de data heeft een duidelijke bron, de beslisregels zijn grotendeels voorspelbaar, succes is controleerbaar, fouten zijn zichtbaar, herstel is mogelijk en de waarde is aantoonbaar. De slechtste kandidaten missen één of meer van die eigenschappen, en dat is bijna altijd al zichtbaar voordat er een regel code is geschreven.
De eerste vraag is daarom niet welke tool je moet gebruiken, maar welk bedrijfsproces je wilt verbeteren, welke informatie daarin beweegt en welke stappen werkelijk automatisch moeten verlopen. Worden meerdere systemen onderdeel van dat proces, dan verschuift de vraag naar integratiearchitectuur: source of truth, synchronisatie, retries, idempotency en monitoring. Dat is het werk achter koppelingen en automatisering, en wat een API-koppeling betrouwbaar maakt werkt die eisen technisch uit.
Twijfel je vervolgens tussen een bestaand automatiseringsplatform en eigen code, dan is dat een keuze per proces en niet één keuze voor het hele bedrijf; Zapier, Make of maatwerk zet die afweging op een rij.
Bronnen
Dit artikel is gebaseerd op het onderzoeksdossier over bedrijfsautomatisering, API-koppelingen en systeemintegraties. Voor technische en operationele uitgangspunten zijn vooral officiële documentatie en standaarden gebruikt.