
Website koppelen aan CRM: van formulier naar lead zonder dubbele gegevens
Een website–CRM-koppeling is meer dan een formulier doorsturen. Goede integraties voorkomen dubbele records, maken eigenaarschap duidelijk en zorgen dat leads betrouwbaar in het juiste proces terechtkomen.
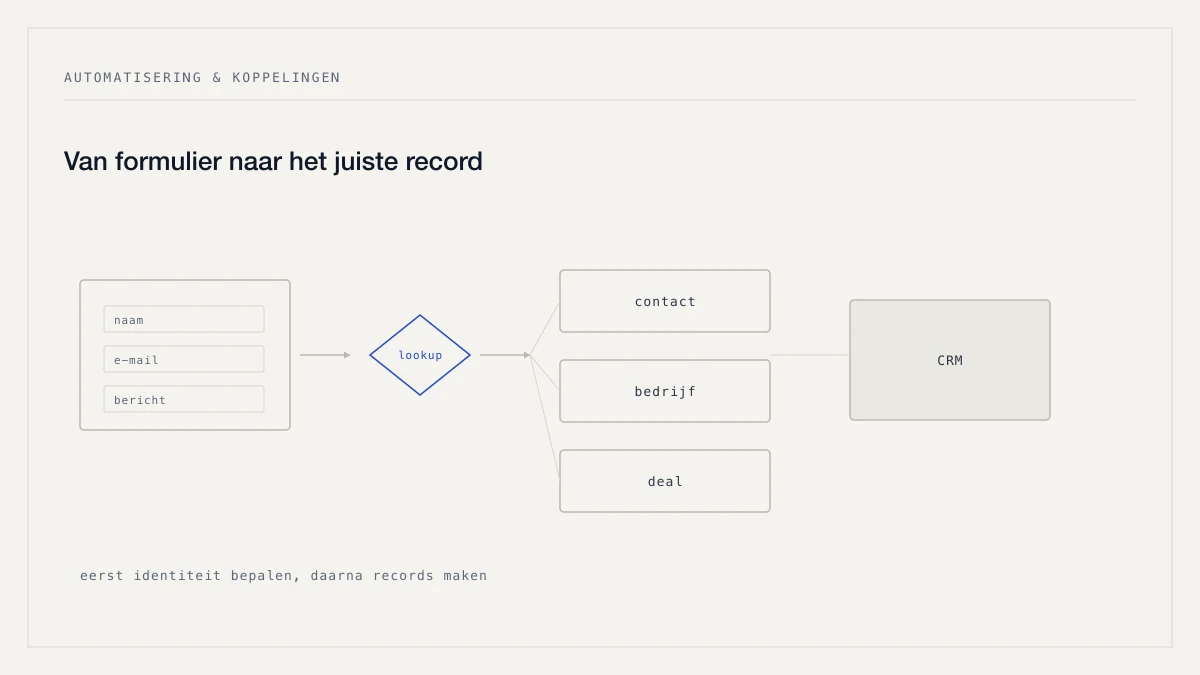
Een website koppelen aan een CRM klinkt eenvoudig: een bezoeker vult een formulier in en de gegevens worden doorgestuurd. In een basisimplementatie is dat inderdaad weinig meer dan een formulier, een API-call en een nieuw contact. Maar zodra die koppeling onderdeel wordt van een echt salesproces, ontstaan vragen die je niet met één request beantwoordt. Bestaat deze persoon al? Hoort de lead bij een bestaand bedrijf? Moet er een nieuw contact, bedrijf of dealrecord komen? Welke velden zijn leidend? Wat gebeurt er als de API tijdelijk onbereikbaar is? Hoe voorkom je dubbele records, wie ontvangt de opvolgtaak en wat gebeurt er met persoonsgegevens in logs en tussenlagen?
Een goede website–CRM-koppeling is daarom geen losse POST-request maar een gecontroleerde informatiestroom, die conceptueel loopt van formulier via validatie, identity en deduplicatie naar contact, bedrijf, deal, activiteit, bevestiging, status en eventuele terugkoppeling. Niet ieder project heeft al die stappen nodig; het model maakt vooral zichtbaar welke verantwoordelijkheden expliciet moeten worden ontworpen.
Waarom rechtstreeks doorsturen te simpel kan zijn
Stel dat een website bij iedere inzending automatisch een nieuw contact aanmaakt. Dat lijkt correct totdat dezelfde persoon een tweede formulier invult, met een ander e-mailadres terugkomt, namens een bestaand bedrijf contact opneemt of al als klant in het CRM staat. Zonder identity- en deduplicatiestrategie kan het CRM langzaam vollopen met dubbele of slecht gekoppelde records. De handmatige invoer is dan verdwenen, maar er is een nieuw datakwaliteitsprobleem ontstaan.
De koppeling moet dus eerst begrijpen wat voor record een inzending vertegenwoordigt en of dat record al bestaat. Welke processen zich überhaupt lenen voor deze vorm van automatisering, staat in welke bedrijfsprocessen je moet automatiseren.
Valideer vóór synchronisatie en geef iedere aanvraag een ID
De eerste controle hoort bij de website te gebeuren. Controleer minimaal of verplichte velden aanwezig zijn, of e-mailadressen een geldig formaat hebben en of waarden binnen toegestane grenzen vallen. Validatie hoort server-side opnieuw plaats te vinden, en niet-vertrouwde input hoort niet blind naar externe systemen te gaan. De CRM-API is geen vervanging voor goede inputvalidatie: ook wanneer een extern systeem aanvullend valideert, wil je voorkomen dat onbruikbare aanvragen onnodig door de integratieketen bewegen.
Geef iedere aanvraag daarnaast een eigen identificatie, bijvoorbeeld een inquiry_id als inq_2026_004821. Die identifier kun je gebruiken in integratielogs, CRM-records, taken, foutmeldingen, retries en interne administratie. Gaat er later iets mis, dan volg je dezelfde aanvraag door de hele keten — betrouwbaarder dan een probleem alleen op naam of e-mailadres proberen terug te vinden.
Contact, bedrijf en deal zijn verschillende objecten
Een CRM is meestal geen platte tabel met leads. Systemen zoals HubSpot modelleren afzonderlijke objecten voor contacts, companies, deals, activiteiten en associaties. Dat onderscheid doet ertoe: één formulierinzending kan leiden tot een persoon die gekoppeld is aan een bedrijf, dat gekoppeld is aan een verkoopkans, waaraan weer een taak voor sales hangt. Wordt alles in één contactrecord gepropt, dan raakt belangrijke procesinformatie verloren.
Een praktische flow begint daarom met een lookup: bestaat het contact, bestaat het bedrijf, gebruiken we bestaande records of maken we nieuwe, en welke relaties leggen we? Welke identifier daarvoor geschikt is, hangt af van het datamodel — een e-mailadres voor personen, een CRM-ID wanneer dat al bekend is, een domeinnaam voor bedrijven, een externe klant-ID of een andere stabiele businessidentifier. HubSpot noemt in zijn company-documentatie domeinnamen als belangrijke unieke identificator voor bedrijven; dat illustreert waarom deduplicatie op objectniveau hoort te worden ontworpen.
Alleen op e-mailadres deduperen is niet altijd genoeg. Iemand kan meerdere adressen gebruiken, van werkgever veranderen of een algemeen adres als info@bedrijf.nl gebruiken. Voor een eenvoudige leadflow kan e-mail voldoende zijn; voor complexere B2B-processen kan een combinatie nodig zijn van contactidentifier, bedrijfsdomein, bestaand CRM-ID en accountrelatie. Een universele deduplicatieregel bestaat niet — de strategie moet aansluiten op het echte bedrijfsproces.
Bij B2B-leads is deduplicatie op contactniveau sowieso onvoldoende, omdat dezelfde organisatie via meerdere medewerkers aanvragen kan sturen. Je wilt voorkomen dat "Acme BV", "Acme B.V.", "ACME" en "acme.nl" als vier losse bedrijven eindigen. Een stabiele identificator als domeinnaam kan helpen, afhankelijk van het CRM en de organisatie, maar de identity-strategie hoort te bestaan voordat records worden aangemaakt.
Upsert in plaats van blind creëren
Wanneer het CRM en de API het ondersteunen, is een lookup-plus-updatepatroon vaak verstandiger dan altijd een nieuw record maken: bestaat het record, werk dan de relevante velden bij; bestaat het niet, maak het dan aan. Belangrijk is wel dat je niet zomaar ieder bestaand veld overschrijft.
Stel dat een bestaande klant een formulier invult met een tijdelijk telefoonnummer. Moet dat automatisch het hoofdnummer in het CRM vervangen? Niet noodzakelijk. Per veld hoort daarom duidelijk te zijn wat de bron is, wat het doel, welke richting geldt, welke trigger de sync start, welke transformatieregel nodig is en welke conflictregel bij afwijking geldt. Bij persoonsgegevens hoort daar het privacydoel bij. Een goede mapping is dus meer dan website.phone → crm.phone; de echte vraag is of deze bron dit veld mag wijzigen, en onder welke voorwaarden.
Source of truth kan daarbij per veld verschillen. Een nieuwe websiteaanvraag komt logischerwijs van de website, maar gekwalificeerde contactdata en interne salesstatus horen bij het CRM, projectdata bij het project- of backofficesysteem, factuurdata bij de administratie en marketingvoorkeur bij het consent- of marketingsysteem. Die verdeling voorkomt dat systemen elkaars gegevens ongecontroleerd blijven overschrijven.
One-way is vaak genoeg
Veel website–CRM-koppelingen hoeven niet bidirectioneel te zijn. De website creëert de aanvraag, het CRM neemt daarna het commerciële proces over — vaak duidelijk en eenvoudig. Soms moet informatie wel terug naar de website of een klantportaal, bijvoorbeeld leadstatus, afspraakstatus, accountgegevens of klantstatus; dan moet opnieuw worden bepaald welke velden terug mogen, wie eigenaar is, welke wijzigingen leidend zijn en hoe loops worden voorkomen. Tweerichtingssynchronisatie is dus niet automatisch "beter geïntegreerd", maar vooral complexer, en zinvol wanneer beide systemen werkelijk wijzigingen moeten initiëren. Wat terugkoppeling naar een ingelogde omgeving betekent, staat verder uitgewerkt in een klantportaal laten maken.
Ook de vraag wát je synchroniseert verdient aandacht. Een veelgemaakte fout is denken dat "goed gekoppeld" betekent dat zoveel mogelijk data heen en weer gaat. Interne salesnotities, handmatig gecorrigeerde CRM-data, afgeleide scores, interne pipelinevelden en velden zonder duidelijke eigenaar wil je meestal niet blind synchroniseren. Het CRM kan na kwalificatie eigenaar worden van salesinformatie, en de website hoeft dan geen interne notities, scoring, dealbedragen of pipelinecommentaar terug te ontvangen. Dat beperkt complexiteit, privacyoppervlak en synchronisatieconflicten.
Maak objecten en relaties bewust aan
Een mogelijke B2B-flow verloopt van formulier naar contact zoeken of aanmaken, bedrijf zoeken of aanmaken, contact aan bedrijf koppelen, een deal of lead aanmaken, bron en aanvraag vastleggen en tot slot een taak voor een medewerker maken. Niet iedere aanvraag hoeft een nieuwe deal te worden: een supportformulier meestal niet, een offerteaanvraag wel, en een bestaande klant met een extra vraag mogelijk een bestaande deal of accountactiviteit. De formulierroute en het CRM-proces moeten dus op elkaar aansluiten.
Daarom bepaalt het formuliertype het downstreamgedrag. Een website kan formulieren hebben voor contact, offerteaanvraag, projectplanner, demoaanvraag, servicevragen en de nieuwsbrief, en het is zelden wenselijk die allemaal via exact dezelfde CRM-flow te sturen. Beter is dat het systeem expliciet weet welk type aanvraag het verwerkt: een quote_request leidt tot een deal en een salestaak, een contact-aanvraag tot een contact of inquiry met triage, en een supportaanvraag tot een supportflow zonder nieuwe deal. Zo voorkom je dat technische eenvoud leidt tot rommelige CRM-data.
Een websiteformulier is bovendien niet altijd een nieuwe lead. Een bestaande klant kan een nieuwe aanvraag doen, support nodig hebben of een uitbreiding willen bespreken. De koppeling moet niet automatisch aannemen dat een formulier gelijkstaat aan een nieuwe lead; een lookup kan bepalen dat het om een bestaand contact bij een bestaand bedrijf gaat, met een nieuwe activiteit of deal in plaats van een compleet nieuw account.
Sales wil daarnaast meer weten dan naam en e-mailadres. Relevante context kan de formulierbron zijn, de pagina of dienst, het projecttype, een vrije toelichting, campagne- of broninformatie waar dat past, de interne aanvraag-ID en het tijdstip. Welke velden je doorstuurt, hangt af van het doel en het privacyprincipe van dataminimalisatie — meer data is niet automatisch beter. En omdat contact, bedrijf en deal afzonderlijke objecten zijn, moeten de associaties ertussen ook bewust worden gelegd. Zonder goede associations kunnen records technisch bestaan en voor sales alsnog moeilijk bruikbaar zijn. Een professionele koppeling maakt dus niet alleen records aan, maar respecteert het commerciële datamodel.
Wat er gebeurt als het misgaat
Na een websiteformulier krijgt de bezoeker vaak een ontvangstbevestiging, en dat is een apart onderdeel van het proces. Staat de aanvraag veilig in je eigen systeem terwijl het CRM tijdelijk onbereikbaar is, dan kan het in sommige architecturen nog steeds wenselijk zijn de klant te bevestigen dat de aanvraag is ontvangen en de CRM-verwerking op de achtergrond opnieuw te proberen. Welke volgorde correct is hangt af van het proces, maar het onderscheid tussen klantcommunicatie en interne CRM-state is belangrijk.
Een externe API kan falen door een timeout, provider outage, rate limit, netwerkprobleem of tijdelijke serverfout. Toont het formulier dan een foutpagina en gaat alle data verloren, dan is de integratie kwetsbaar. Robuuster is: de eigen aanvraag veilig opslaan, de CRM-sync proberen, bij een tijdelijke fout opnieuw proberen en bij een blijvende fout alerteren en herstellen. Zo wordt de website niet volledig afhankelijk van één directe externe call.
Retries mogen daarbij geen dubbele contacten creëren. Stuurt de koppeling een create contact, maakt het CRM het contact aan maar bereikt het antwoord de website niet, dan denkt de koppeling dat de actie is mislukt en voert dezelfde create opnieuw uit — met twee records tot gevolg. Deduplicatie hoort dus niet alleen vóór de eerste poging te bestaan maar ook onderdeel te zijn van retrygedrag, via stabiele externe identifiers, een lookup vóór create, provider-supported idempotency waar beschikbaar en een eigen verwerkingsstatus. Dezelfde logica geldt voor dubbele submits door dubbelklikken, een slechte verbinding, een browserretry of een onzekere gebruiker: een unieke submission-ID, server-side deduplicatie, een korte idempotencywindow of een CRM-lookup voorkomen dat één aanvraag onbeperkt nieuwe records maakt. De implementatie verschilt per applicatie, maar de foutmodus hoort vooraf bekend te zijn. Deze patronen gelden breder dan CRM alleen; een API-koppeling laten maken behandelt ze in algemene vorm.
Bij een fout wil je kunnen reconstrueren wat er gebeurde. Nuttige logcontext is bijvoorbeeld de inquiry_id, het CRM-object-ID, een job-ID, het pogingnummer, een timestamp, het resultaat en het fouttype. Wat je juist niet langdurig wilt bewaren zijn volledige tokens, wachtwoorden, onnodige persoonsgegevens en volledige formulierpayloads. Logging moet diagnose mogelijk maken zonder zelf een privacy- of securityprobleem te worden.
Merk je het als de koppeling stilvalt?
Een koppeling kan maanden goed werken en daarna stoppen door een gewijzigde API-versie, een verlopen credential, een gewijzigd endpoint, een rate limit of een providerstoring. Merkt niemand dat, dan stapelen websiteaanvragen zich mogelijk buiten het CRM op. Een professionele integratie geeft daarom antwoord op hoe fouten worden gedetecteerd, wie een alert ontvangt, waar mislukte syncs zichtbaar zijn en hoe ze opnieuw worden uitgevoerd. Een koppeling is pas operationeel bruikbaar als iemand ook weet wanneer hij niet werkt.
Realtime is daarbij geen absoluut kwaliteitscriterium. Een website kan de aanvraag opslaan, een job in de queue zetten en het CRM binnen enkele seconden bijwerken — vaak betrouwbaarder dan de hele gebruikerservaring laten wachten op een externe API. Belangrijker dan absolute snelheid is dat aanvragen niet verloren gaan, niet dubbel ontstaan, zichtbaar verwerkt worden en herstelbaar blijven.
Ook volume verdient aandacht. Een normaal websiteformulier heeft laag volume, maar na campagnes kunnen pieken optreden. Veroorzaakt iedere inzending een contact lookup, company lookup, create of update, association, deal create en task create, dan kost één formulier al meerdere API-verzoeken. Rate limits, retries, concurrency en batching waar relevant horen dus bewust ontworpen te zijn — dat vraagt geen ingewikkelde infrastructuur, wel een expliciete keuze.
Privacy, secrets en tussenlagen
Een CRM-koppeling verwerkt meestal persoonsgegevens, dus moet vooraf duidelijk zijn welke gegevens werkelijk nodig zijn. Vraag per veld waarom je het doorstuurt, welk systeem het nodig heeft, hoe lang het blijft bestaan en wie het kan zien. Onder de AVG zijn onder andere doelbinding, dataminimalisatie en opslagbeperking relevante principes; een koppeling hoort dus niet ieder websiteveld "voor de zekerheid" te synchroniseren.
De datastroom is bovendien vaak langer dan website-naar-CRM. Er kan een integratielaag, een automatiseringsplatform en een e-mailprovider tussen zitten, en dan tellen ook logs, queues, subprocessors, tijdelijke opslag en recoverydata mee. Privacy stopt niet bij het einddoel.
Een CRM-secret, private API-key of andere geprivilegieerde credential hoort daarnaast niet in browsercode. De frontend is geen veilige opslagplaats voor servercredentials. Een professionele flow loopt van browser via de eigen server of API naar het CRM, waar authenticatie, validatie en secretbeheer gecontroleerd kunnen plaatsvinden.
Checklist vóór implementatie
Voordat je een website aan een CRM koppelt, hoort duidelijk te zijn welke formulieren er zijn, welke velden ze bevatten, welke verplicht zijn en welke werkelijk nodig zijn in het CRM. Aan de identity-kant: hoe herkennen we een bestaand contact, hoe een bestaand bedrijf, en welke identifiers zijn stabiel? Aan de modelkant: welke objecten gebruiken we — contact, company, deal, task, activity? Bij mapping: welk websiteveld gaat naar welk CRM-veld, mag het bestaande data overschrijven en welke transforms zijn nodig? Bij source of truth: welk systeem is eigenaar van ieder belangrijk veld, en is synchronisatie one-way of two-way?
Voor fouten: wat gebeurt er bij CRM-downtime, kunnen requests opnieuw worden uitgevoerd, hoe voorkomen we duplicaten en waar zijn failures zichtbaar? Voor security: waar staan credentials, welke scopes zijn nodig en wordt input server-side gevalideerd? Voor privacy: welke persoonsgegevens bewegen, welke velden zijn noodzakelijk, hoe lang worden logs en queues bewaard en welke externe partijen verwerken data? En voor operations: hoe wordt de koppeling gemonitord, wie ontvangt alerts en hoe worden mislukte aanvragen hersteld?
Een koppeling is bovendien afhankelijk van externe software die verandert: API-versioning, nieuwe authvereisten, gewijzigde objectvelden, deprecated endpoints, aangepaste rate limits en veranderde scopes. Een koppeling heeft daarom niet alleen een implementatieplan nodig maar ook een onderhoudsmodel. Of je dit met een automatiseringsplatform of met maatwerk inricht, is een aparte afweging die staat uitgewerkt in Zapier, Make of maatwerk.
Het doel is een beter proces, niet alleen datatransfer
Het doel is niet dat een website technisch een CRM-record kan aanmaken, maar dat een aanvraag betrouwbaar onderdeel wordt van het commerciële proces: de juiste aanvraag komt bij de juiste identiteit terecht, wordt vertaald naar de juiste CRM-objecten en relaties, belandt bij de juiste medewerker, krijgt een zichtbare status en blijft herstelbaar bij fouten.
Is dat goed ontworpen, dan verdwijnt een deel van de handmatige overdracht zonder dat het CRM verandert in een verzameling dubbele contacten, losse bedrijven en onduidelijke deals. Een professionele website–CRM-koppeling begint daarom niet bij de API-call, maar bij de vraag welke informatie een aanvraag vertegenwoordigt, waar die thuishoort en wie eigenaar is van die data. Hulp nodig bij het inrichten daarvan? Kijk bij koppelingen en automatisering.
Bronnen
Dit artikel is gebaseerd op het onderzoeksdossier over bedrijfsautomatisering, systeemintegraties en API-koppelingen. HubSpot wordt gebruikt als concreet documentatievoorbeeld van CRM-objecten en associations; de principes zijn niet beperkt tot één CRM-platform.