
API-koppeling laten maken: wat maakt een integratie betrouwbaar, complex en onderhoudbaar?
Een API-koppeling is meer dan twee systemen met elkaar laten praten. Betrouwbare integraties vragen om duidelijke data-eigenaarschap, foutafhandeling, retries, idempotency, monitoring en onderhoud.
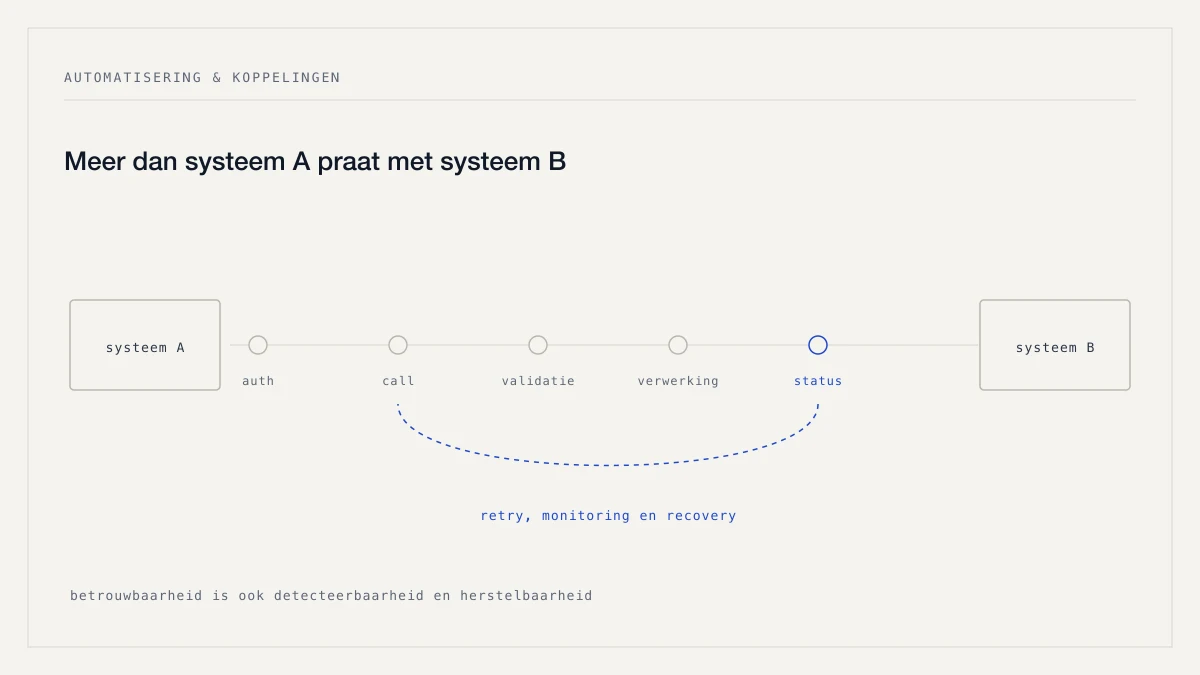
Een API-koppeling wordt meestal uitgelegd als: systeem A praat met systeem B. Technisch is dat maar een klein deel van het verhaal, en het is precies het deel dat zelden misgaat. Een professionele integratie moet niet alleen gegevens kunnen versturen en ontvangen, maar ook weten welke data leidend is, wat er gebeurt bij fouten, hoe dubbele verwerking wordt voorkomen, hoe wijzigingen worden gesynchroniseerd en hoe iemand merkt dat de koppeling niet meer werkt.
Dat is het verschil tussen een demo die een succesvolle API-call kan uitvoeren en een integratie die onderdeel mag worden van een echt bedrijfsproces. De eerste laat zien dat verbinding mogelijk is. De tweede moet overeind blijven als een externe dienst traag reageert, een netwerkverbinding wegvalt, een leverancier zijn authenticatie wijzigt of iemand dezelfde order per ongeluk twee keer aanbiedt. Bij bedrijfskritische koppelingen komen daar versiebeheer, een audit trail, idempotency en periodieke controle op afwijkingen bij.
Een API hebben zegt nog weinig
Een API is een interface waarmee software functies of gegevens van andere software kan gebruiken. Bij moderne bedrijfssoftware gebeurt dat meestal via HTTP: een client stuurt een verzoek en de server antwoordt met een statuscode, gegevens of een foutmelding. Daarmee kan een koppeling een CRM-contact aanmaken, een order ophalen, een factuurstatus synchroniseren, voorraad bijwerken, een afspraak inplannen of productgegevens uitlezen.
De aanwezigheid van een API zegt alleen weinig over de uiteindelijke complexiteit. Een leverancier kan er een hebben terwijl bepaalde data niet beschikbaar is, mutaties niet worden ondersteund, de authenticatie omslachtig is, er strenge rate limits gelden, webhooks ontbreken of het versiebeheer veel aandacht vraagt. De eerste vraag is daarom niet of een systeem een API heeft, maar of die API precies de gegevens en acties biedt die dit bedrijfsproces nodig heeft, onder voorwaarden die betrouwbaar te beheren zijn.
Je kunt een API het beste zien als een contract tussen twee systemen, en dat contract omvat meer dan een lijst endpoints. Het legt vast hoe authenticatie werkt, welke rechten of scopes nodig zijn, welke objecten beschikbaar zijn, welke velden gelezen of gewijzigd mogen worden, hoe grote datasets worden gepagineerd, welke rate limits gelden, hoe fouten worden gerapporteerd, hoe versies veranderen, of webhooks beschikbaar zijn en hoe updates veilig opnieuw kunnen worden uitgevoerd. Twee API's met vergelijkbare functionaliteit kunnen daardoor sterk verschillen in implementatie- en onderhoudswerk.
Toegang: wie mag wat, en hoe lang
Een integratie moet bewijzen wie of welk systeem toegang krijgt. In de praktijk gebeurt dat met een API-key, met OAuth 2.0 of met een provider-specifieke variant daarvan. Een API-key past goed bij communicatie tussen servers, mits die sleutel niet in browsercode belandt, niet in een publieke repository terechtkomt, server-side wordt bewaard en kan worden ingetrokken of vervangen. Een key is namelijk geen beveiligingsstrategie op zichzelf; de relevante vragen zijn waar hij staat, wat hij mag, hoe hij geroteerd wordt en hoe misbruik wordt gedetecteerd.
OAuth komt in beeld wanneer een integratie namens een gebruiker of organisatie toegang krijgt tot een extern platform. Dan spelen autorisatie, access tokens, refresh tokens, scopes, verlooptijden en intrekking allemaal een rol. Een integratie met één servercredential is daardoor meestal aanzienlijk eenvoudiger dan een multi-tenant OAuth-flow voor veel klanten — een verschil dat in offertes vaak onzichtbaar blijft omdat beide "een koppeling" heten.
Waar authenticatie de vraag beantwoordt wie je bent, beantwoordt autorisatie de vraag wat je mag. Een koppeling hoort bij voorkeur alleen toegang te krijgen tot wat het proces werkelijk nodig heeft: wel contacten lezen en deals schrijven, bijvoorbeeld, maar geen toegang tot de financiële administratie. Dat principe van least privilege beperkt de schade wanneer credentials uitlekken of verkeerd worden gebruikt, en het is een van de weinige maatregelen die vrijwel niets kost.
Welk systeem is eigenaar van welk gegeven?
Een integratie wordt snel complexer wanneer meerdere objecttypen aan elkaar gekoppeld zijn. Een CRM bevat zelden één lijst met klanten; het kent afzonderlijke objecten voor contacten, bedrijven, deals, activiteiten en taken, met relaties daartussen. Een webshop bestaat uit producten, varianten, klanten, orders, betalingen, fulfillments en retouren. Een goede integratie begint daarom bij het begrijpen van beide datamodellen: welk object hoort bij welke zakelijke betekenis, hoe zijn objecten aan elkaar gekoppeld, en welk systeem mag welke informatie bepalen?
Die laatste vraag is de belangrijkste ontwerpbeslissing van het hele project. Voor iedere relevante dataset moet expliciet duidelijk zijn wie eigenaar is. Contactgegevens horen doorgaans thuis in het CRM, een webshoporder in de webshop, voorraad in het ERP of WMS, de definitieve factuur in de boekhouding, de betalingsstatus bij de betaalprovider of de administratie, en de productprijs in één centrale pricingbron. Andere systemen mogen die data vervolgens consumeren of spiegelen, maar niet zelfstandig herschrijven.
Zonder die afspraak verandert synchronisatie in conflictmanagement. Mogen zowel het CRM als de boekhouding een adres aanpassen, dan ontstaat bij elke afwijking de vraag welke waarde correct is — en dat is een vraag die software niet voor je kan beantwoorden. Is systeem A eigenaar en hoeft systeem B alleen mee te lezen, dan volstaat een one-way sync, en die is aanzienlijk eenvoudiger. Tweerichtingssynchronisatie is alleen nodig wanneer beide kanten legitiem wijzigingen mogen initiëren, en vraagt dan om eigenaarschap per veld, timestamps, versies, conflictregels en bescherming tegen loops, zodat een wijziging die uit het CRM kwam niet via het portaal als nieuwe mutatie terugkomt.
Wanneer weet je dat er iets is veranderd?
Systemen kunnen wijzigingen op twee manieren ontdekken. Bij een webhook meldt de bron actief dat er iets is gebeurd — een betaling voltooid, waarna de orderverwerking start. Dat is snel, kost weinig onnodige API-calls en past goed bij event-driven processen. Bij polling vraagt het ontvangende systeem periodiek of er iets is veranderd, bijvoorbeeld elke tien minuten de gewijzigde records. Dat kost meer calls en introduceert vertraging, maar werkt ook als de provider geen webhooks ondersteunt, past bij batchverwerking en is bruikbaar voor periodieke controle.
De keuze hangt af van het proces, en in robuuste systemen worden beide gecombineerd: webhooks voor snelheid, en een periodieke controle voor zekerheid. Die zekerheid is geen luxe, want een veelgemaakte fout is aannemen dat iedere webhook precies één keer aankomt, in de juiste volgorde, altijd, en onbeperkt opnieuw wordt geprobeerd. Providerbeleid verschilt daarin sterk. De integratie moet daarom zelf rekening houden met duplicaten, downtime, retrygedrag, redelivery en unieke event-ID's. Een webhook is een notificatiemechanisme, geen garantie dat de bijbehorende bedrijfsactie correct is uitgevoerd.
Opnieuw proberen is niet vanzelf veilig
Bij een tijdelijke fout lijkt het logisch om dezelfde actie nog eens uit te voeren. Bij leesacties is dat meestal onschuldig. Bij mutaties kan het gevaarlijk worden, en dat is het punt waarop integraties in de praktijk het vaakst stuklopen.
Stel dat een order een factuur moet krijgen. Het verzoek gaat weg, maar de netwerkverbinding valt weg vlak voordat het antwoord terugkomt. De client weet nu niet of de server de factuur wel of niet heeft aangemaakt. Blind opnieuw proberen levert dan twee facturen op voor dezelfde order — met twee nummers, in de boekhouding, bij de klant. Idempotency lost dat op: door dezelfde opdracht van een stabiele sleutel te voorzien, kan de provider of de eigen integratielaag herkennen dat die operatie al is verwerkt en hem niet nog een keer uitvoeren. Dat is vooral belangrijk bij betalingen, facturen, orders, voorraadmutaties en andere financiële of operationele schrijfacties.
Hetzelfde geldt voor processen die uit meerdere stappen bestaan. Een commerceflow loopt bijvoorbeeld van webshop naar betaling, administratie, voorraad en bevestigingsmail. Slaagt de betaling, wordt de factuur aangemaakt, maar faalt de voorraadupdate, dan is de juiste reactie zelden om de hele workflow opnieuw te starten. De koppeling moet weten welke stappen al definitief zijn uitgevoerd en waar hervatten veilig is. Dat vraagt om een opzet waarin ieder event of iedere opdracht een eigen identificatie krijgt, het resultaat wordt vastgelegd, tijdelijke fouten opnieuw worden geprobeerd, blijvende fouten in een recoverywachtrij belanden en iemand een melding krijgt die handmatig kan corrigeren. Dat is geen detail van de implementatie; dat ís de integratiearchitectuur.
Betrouwbaarheid is ook detecteerbaarheid
Stel dat een workflow duizend keer per maand draait met een succespercentage van vijfennegentig procent. Dat klinkt acceptabel tot je het omrekent: vijftig uitzonderingen per maand. Weet niemand welke vijftig records zijn mislukt, dan is het geautomatiseerde proces operationeel slechter dan het handmatige proces dat het verving, want daar waren fouten tenminste zichtbaar. Naast het succespercentage tellen daarom drie andere vragen: kun je failures detecteren, kun je zien welke records geraakt zijn, en kun je veilig opnieuw uitvoeren of handmatig herstellen?
Om die vragen te kunnen beantwoorden hoor je vier dingen uit elkaar te houden die vaak op één hoop belanden. Logging legt technische gebeurtenissen vast en helpt bij diagnose: welk verzoek, welke job, welk resultaat, welk fouttype, wanneer. Monitoring detecteert dat er iets afwijkends gebeurt — een stijgend foutpercentage, een oplopende wachtrij, webhookverkeer dat stilvalt, verwerking die ineens veel langer duurt. Een audit trail beantwoordt de zakelijke vraag wat er wanneer is veranderd en door welk proces, wat vooral telt wanneer wijzigingen later verklaard moeten kunnen worden. En recovery maakt herstel mogelijk: een job opnieuw uitvoeren, een record corrigeren, een event opnieuw afspelen. Bij kritieke integraties is foutafhandeling dus veel meer dan een try-catch.
Zelfs een goed opgezette event-driven koppeling kan events missen of tijdelijk onbereikbaar zijn. Daarom is periodieke reconciliation zinvol: elke nacht de orders van de vorige dag tussen webshop en ERP vergelijken en afwijkingen apart herstellen. Dat is vooral nuttig voor processen waarin volledigheid zwaarder weegt dan realtime gedrag.
Volume, limieten en versies
Veel API's beperken hoeveel verzoeken je in een bepaalde periode mag doen. Bij laag volume merk je daar niets van. Bij hogere volumes moet het ontwerp rekening houden met throttling, wachtrijen, batching, backoff, pagination en concurrency — waardoor dezelfde koppeling op kleine en grote schaal technisch een ander probleem wordt. Grote datasets komen bovendien zelden in één antwoord terug, dus moet de integratie pagina voor pagina of via cursors doorlopen. Dat speelt vooral bij grote klantenbestanden, historische orders, backfills en periodieke bulkupdates.
Daar komt bij dat een koppeling niet één keer gebouwd en daarna vergeten wordt. Externe platforms veranderen: nieuwe API-versies, uitgefaseerde endpoints, gewijzigde webhook-events, aangepaste rate limits, andere authenticatie, verlopen credentials, gewijzigde datamodellen, storingen aan de kant van de provider, nieuwe usagekosten of een gewijzigd intern bedrijfsproces. Onderhoud hoort daarom vanaf het begin onderdeel van de architectuur te zijn, en niet pas ter sprake te komen als er iets stukgaat.
Dat onderhoud is bovendien iets anders dan doorontwikkeling, hoewel de twee commercieel vaak door elkaar lopen. Onderhoud houdt bestaande functionaliteit werkend: een API-versie bijwerken, een credential vervangen, een endpoint migreren, monitoring herstellen. Nieuwe functionaliteit breidt het proces uit: een extra systeem koppelen, een nieuwe workflowstatus toevoegen, een nieuw documenttype ondersteunen, een businessregel toevoegen. Dat onderscheid bepaalt hoe support- en doorontwikkelafspraken eruitzien, en het loopt parallel aan wat er verder bij technisch onderhoud na livegang komt kijken.
Wat de kosten werkelijk bepaalt
Een generiek eurobedrag zonder scope zegt hier weinig. De technische complexiteit — en daarmee de prijs — wordt bepaald door een reeks factoren die per project sterk verschillen. De onderstaande vergelijking laat zien waar de scope groeit, en waarom twee projecten die allebei "een API-koppeling" heten toch een andere orde van grootte kunnen hebben.
| Factor | Relatief eenvoudig | Complexer |
|---|---|---|
| Aantal systemen | 2 | meerdere systemen in één keten |
| API-kwaliteit | volledig en stabiel | beperkt of inconsistent |
| Authenticatie | eenvoudige servercredential | OAuth / multi-tenant |
| Datamodel | één object | klanten, orders, producten, documenten en statussen |
| Richting | one-way | two-way |
| Timing | batch | near-real-time |
| Volume | laag | hoog en concurrent |
| Foutafhandeling | handmatig herstel | automatische retry + reconciliation |
| Historische data | alleen nieuwe records | migratie / backfill |
| Businessregels | directe mapping | veel transformaties en uitzonderingen |
| Kritikaliteit | interne convenience | geld, voorraad, fulfillment |
| Monitoring | basisalert | audit, dashboards, replay en recovery |
| Privacy | beperkte data | uitgebreide persoonsgegevens |
| Onderhoud | stabiele dependencies | veel externe changes |
Grofweg vallen koppelingen daarmee in drie categorieën uiteen. Eenvoudige automatisering verbindt twee systemen in één richting met standaardvelden, beperkt volume en fouten die handmatig te herstellen zijn; daar is weinig architectuur voor nodig. Een bedrijfsintegratie voegt OAuth, meerdere objecten, webhooks, retries, logging, monitoring en historische data toe, en betrouwbaarheid wordt dan een substantieel deel van de scope. Een bedrijfskritische integratielaag met meerdere systemen, tweerichtingssynchronisatie, hoge volumes, voorraad- of financiële state, reconciliation en een herstelinterface is geen koppeling meer maar een operationeel systeem — met de scopefactoren die ook gelden bij wat een webapplicatie kost.
Security en privacy over de hele keten
Een professionele integratie houdt zich aan een beperkt aantal uitgangspunten die zelden ter discussie staan. Geheime sleutels horen server-side en niet in clientcode of publieke repositories. Een koppeling krijgt alleen de rechten die ze nodig heeft. Credentials moeten vervangen kunnen worden zonder grote codewijziging. Webhooks worden gevalideerd op signature of secret voordat events worden verwerkt. Ook data van vertrouwde API's wordt gevalideerd. Rate limits en timeouts begrenzen resourcegebruik, zodat één trage externe dienst niet de hele applicatie blokkeert. En logging bevat genoeg context voor diagnose maar geen tokens, wachtwoorden of onnodige persoonsgegevens.
Privacy verdient daarbij een bredere blik dan alleen het einddoel. Een integratie creëert vaak een keten waarin gegevens van de website via een integratielaag naar het CRM lopen, en vandaar naar een automatiseringsplatform, een e-mailprovider en de boekhouding. Voor persoonsgegevens telt die hele keten: welke velden bewegen, waarom ze nodig zijn, welke partijen ze verwerken, waar ze worden opgeslagen, hoe lang logs en wachtrijen blijven bestaan, wie toegang heeft en wat er gebeurt bij verwijdering. Dataminimalisatie geldt daarmee ook voor integratielogs, snapshots en tussenlagen — precies de plekken waar niemand kijkt.
Twee voorbeelden uit de praktijk
Een commerceflow laat goed zien waarom eigenaarschap zo bepalend is. Een order doorloopt achtereenvolgens de statussen aangemaakt, betaling in behandeling, betaald, toegewezen, verzonden, gefactureerd en eventueel geretourneerd of terugbetaald. Per status is een ander systeem eigenaar: de webshop bezit de order, de betaalprovider de betaalstatus, het ERP de voorraad, de boekhouding de definitieve factuur en het fulfilmentplatform de verzendstatus. De integratie vertaalt tussen die verantwoordelijkheden en probeert juist niet van elk systeem de eigenaar van alles te maken.
Een eenvoudiger geval is een websiteformulier dat een lead in het CRM moet opleveren. Daar loopt de flow van formulier via validatie en een eigen aanvraag-ID naar een CRM-lookup, het aanmaken of bijwerken van contact en bedrijf, een deal, een taak en een ontvangstbevestiging. Ook hier gelden dezelfde principes van deduplicatie, eigenaarschap, retries, logging en privacy. De specifieke uitwerking van die use-case staat in website koppelen aan CRM.
Wat je een leverancier zou moeten vragen
Wanneer je een API-koppeling laat bouwen, leveren de volgende vragen meer inzicht op dan de vraag in welke programmeertaal er wordt gewerkt:
- Welk systeem is per object of veld leidend, welke objecten en statussen worden gesynchroniseerd, en is de koppeling one-way of two-way?
- Wat gebeurt er als een API tijdelijk niet bereikbaar is, zijn writes idempotent, hoe worden dubbele events voorkomen, en is er reconciliation?
- Hoe wordt zichtbaar dat de koppeling faalt, kunnen mislukte jobs opnieuw worden uitgevoerd, en bestaat er een herstelproces?
- Waar worden credentials opgeslagen, welke scopes gebruikt de koppeling, en hoe worden webhooks gevalideerd?
- Wie bewaakt API-deprecations, wat gebeurt er bij breaking changes, en hoe worden credentials en webhooksubscriptions vernieuwd?
- Welke externe usagekosten bestaan er, hoe beïnvloeden volumes de infrastructuur, en zitten monitoring en beheer in de scope?
Een goede technische partner kan daar concreet op antwoorden. Kan iemand dat niet, dan is dat op zichzelf al informatie.
Een koppeling is een operationeel systeem
De code die een verzoek verstuurt is doorgaans het eenvoudigste deel. De kwaliteit zit in de architectuur eromheen: een duidelijke source of truth, begrensde rechten, een correct datamodel, veilige retries, idempotency, conflictregels, afhandeling van gedeeltelijke fouten, logging, monitoring, recovery, reconciliation en onderhoud.
Beoordeel een API-koppeling daarom niet op de vraag of de happy path werkt, maar op wat er gebeurt wanneer één onderdeel uitvalt, data afwijkt of een externe leverancier iets verandert. Dat bepaalt uiteindelijk of een integratie betrouwbaar genoeg is om deel uit te maken van een serieus bedrijfsproces. Dat werk zit bij koppelingen en automatisering.
Wil je eerst bepalen welke processen überhaupt geschikt zijn om te automatiseren, dan is welke bedrijfsprocessen je wel en niet moet automatiseren het logische vertrekpunt. Twijfel je tussen een automatiseringsplatform en eigen integratiecode, dan zet Zapier, Make of maatwerk die afweging per proces op een rij.
Bronnen
Dit artikel is gebaseerd op het onderzoeksdossier over bedrijfsautomatisering en systeemintegraties. Voor technische uitgangspunten zijn primair officiële standaarden en documentatie gebruikt.
- RFC 9110 — HTTP Semantics
- RFC 6749 — OAuth 2.0
- Stripe API documentation
- Stripe — error handling
- Stripe — rate limits
- Stripe — undelivered webhook events
- GitHub — webhook best practices
- GitHub — validating webhook deliveries
- GitHub — API versions
- Google Calendar — synchronize resources efficiently
- OWASP API Security Top 10
- European Commission — GDPR principles