
Hoe werkt een 3D-productconfigurator technisch? Architectuur, productregels en performance
Een professionele 3D-productconfigurator bestaat uit veel meer dan een 3D-model. Dit artikel legt uit hoe configuratiestate, productregels, pricing, rendering, data, integraties en performance samenwerken.
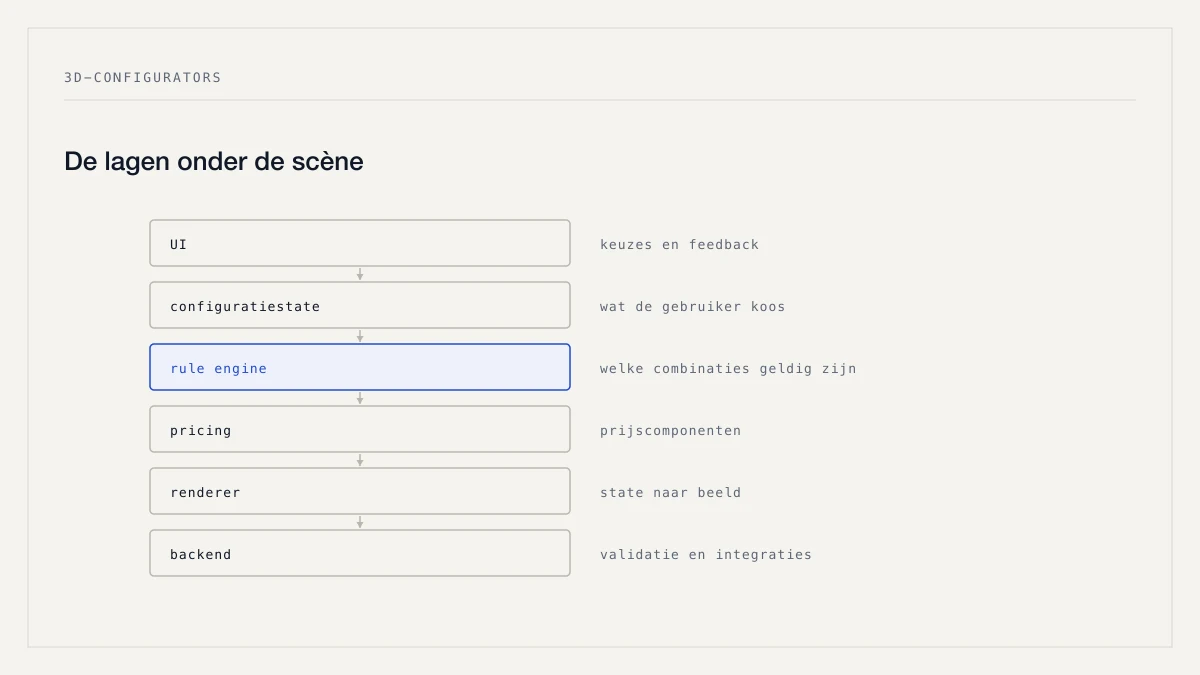
Een professionele 3D-productconfigurator is geen 3D-scène met een paar knoppen eromheen. De kern van het systeem is een configureerbaar productmodel. De 3D-laag visualiseert wat de gebruiker heeft samengesteld, maar hoort niet zelf te bepalen welke combinatie technisch geldig is, wat iets kost of welke gegevens naar een offerte of order moeten.
Conceptueel loopt een robuuste architectuur van de UI naar een canonieke configuratiestate, die door een rule engine tegen de productdata wordt getoetst, waarna afgeleide waarden en prijzen worden berekend, de renderer het resultaat toont en de backend het geheel bewaart, valideert en doorgeeft aan database, CRM, ERP, offerte of order. Het sleutelidee is eenvoudig: de renderer toont wat de configuratielaag heeft besloten en is niet de bron van waarheid voor productlogica, prijs of maakbaarheid. Dat onderscheid bepaalt voor een groot deel of een configurator later goed te testen, beheren, integreren en uitbreiden is. Wat zo'n systeem functioneel is, staat in wat een 3D-productconfigurator is.
De configuratiestate is het hart van het systeem
Een configurator heeft een centrale toestand nodig waarin staat wat de gebruiker daadwerkelijk heeft gekozen: de productfamilie, de productversie, de breedte en diepte in millimeters, het daktype, de framekleur en welke zijwanden aan of uit staan. Dat is de canonieke configuratiestate, en vanuit die state kunnen alle andere delen van de applicatie hun werk doen. De rule engine controleert of de combinatie geldig is, afgeleide waarden worden berekend, de pricing engine bepaalt prijscomponenten, de renderer bepaalt welke geometrie en materialen zichtbaar zijn, de backend bewaart of valideert de configuratie en integraties vertalen de data naar CRM, ERP, offerte of order.
Waarom niet de 3D-scène als bron van waarheid gebruiken? Een scene graph beschrijft vooral wat zichtbaar is: welke meshes bestaan, welke objecten aan of uit staan, welke materialen actief zijn en hoe objecten zijn getransformeerd. Dat is iets anders dan een productmodel. Een zichtbaar object met de naam post_03 zegt niet waarom dat object nodig is, welke regel het heeft geactiveerd of welke commerciële betekenis het heeft. Wordt "mesh zichtbaar" de enige vastlegging van een keuze, dan raakt productlogica verstopt in de renderinglaag — en worden latere functies als opslaan, prijsberekening, server-side validatie of ERP-integratie onnodig moeilijk.
Naast de actuele state is een productdefinitie nodig die beschrijft wát er geconfigureerd kan worden: beschikbare eigenschappen, datatypes, toegestane waarden, standaardwaarden, technische grenzen, conditionele zichtbaarheid, productfamilies, relaties tussen opties en downstream mappings. Per attribuut gaat het dan om datatype, toegestaan domein, default, zichtbaarheidsvoorwaarden, validatieregels, afgeleide regels en de vertaling naar downstream systemen. Niet ieder project hoeft daarvoor een generiek regelsysteem te bouwen — bij een relatief eenvoudig product kunnen gewone tabellen, schema's en goed afgebakende functies voldoende zijn. Belangrijk is vooral dat de productdefinitie niet verspreid raakt over willekeurige frontendcomponenten.
De rule engine bewaakt geldige configuraties
Een echte productconfigurator moet meer doen dan opties tonen; hij moet begrijpen welke configuraties zijn toegestaan. Dat begint bij bereikregels — een breedte tussen 2000 en 6000 mm — en stapgroottes, bijvoorbeeld alleen instelbaar per 50 mm. Daarnaast zijn er vereisten (zijwand A vereist profiel B), uitsluitingen (materiaal X gaat niet samen met uitvoering Y), conditionele beschikbaarheid (een motoroptie pas vanaf een bepaalde maat) en relationele regels (de hoogte mag niet boven een bepaalde verhouding tot de breedte uitkomen). Verder kunnen waarden worden afgeleid, zoals het aantal modules als functie van totale breedte en modulemaat, en kunnen commerciële keuzes downstream bepalen welke onderdelen of bewerkingen nodig zijn. Hoe ingewikkelder die onderlinge afhankelijkheden worden, hoe belangrijker het is dat de regels als zelfstandig domein worden behandeld.
Een frontendvoorwaarde is daarbij niet hetzelfde als een productregel. Een controle die bij een breedte boven 5000 mm een extra staander toont, kan lokaal prima werken. Het probleem ontstaat wanneer dezelfde regel ook nodig is voor prijsberekening, offertevalidatie, orderimport, interne sales, ERP-mapping of server-side controle. Dan is een frontendvoorwaarde geen geschikte enige bron van waarheid: de UI mag snel feedback geven, maar de semantiek van de regel hoort op een plek te staan waar andere lagen er eveneens gebruik van kunnen maken.
Niet iedere waarde hoeft bovendien rechtstreeks door de gebruiker te worden gekozen. Een configurator kan het aantal staanders, het totale oppervlak, het aantal modules, de benodigde profielen, het technische gewicht, de materiaalhoeveelheid en de beschikbare accessoires uit de keuzes afleiden. Een belangrijk architectuurprincipe is dat zulke waarden deterministisch uit de bronkeuzes volgen, zodat dezelfde informatie niet op meerdere plekken los hoeft te worden opgeslagen. De volgorde is dan: expliciete gebruikerskeuzes, validatie, afgeleide productwaarden en pas daarna pricing, rendering en downstream output. Dat maakt een configuratie makkelijker te reproduceren en te testen.
Pricing hoort een eigen verantwoordelijkheid te zijn
Prijsberekening is vaak nauwer verbonden met productlogica dan met de visuele interface. Een configurator kan werken met een basisprijs, vaste toeslagen, prijs per stuk, per meter of per vierkante meter, met staffels, matrices, formules, combinatietoeslagen, minimumprijzen en kanaal- of klantspecifieke regels. Een totaal kan bijvoorbeeld bestaan uit de basisprijs plus oppervlakte maal materiaaltarief, plus het aantal staanders maal een stukprijs, plus een glastoeslag en montageopties — waarbij in werkelijkheid ook afrondingsregels, minimumwaarden en familiespecifieke uitzonderingen meespelen.
Voor een prettige UX kan de frontend die prijs direct berekenen of tonen. Maar zodra de prijs commercieel bindend wordt, is het verstandig dat een gezaghebbende backend- of pricinglaag bij verzending opnieuw valideert. Anders wordt de browser de enige autoriteit voor iets wat rechtstreeks doorwerkt naar offerte of order. Een prijsvoorbeeld in de frontend is dus iets anders dan een gevalideerde orderprijs. Bij een puur indicatieve prijs kan de architectuur eenvoudiger zijn; bij een directe checkout liggen de eisen veel hoger. Welke van die keuzes je maakt, werkt sterk door in de scope — zie wat een 3D-productconfigurator kost.
De renderlaag: WebGL, Three.js en glTF
Pas nadat configuratie en regels zijn bepaald, komt de renderlaag in beeld. In de browser wordt interactieve 3D doorgaans opgebouwd bovenop GPU-versnelde rendering via WebGL of een hoger abstractieniveau. Three.js is een veelgebruikte bibliotheek die concepten aanbiedt als scenes, camera's, geometrieën, materialen, textures, lights, loaders en renderers, zodat een applicatie niet voor ieder project rechtstreeks met low-level WebGL-buffers en shaders hoeft te werken. Maar Three.js is geen productconfiguratorframework: het lost niet op welke productopties geldig zijn, hoe prijzen worden berekend, hoe productdata wordt beheerd, hoe configuraties worden opgeslagen of hoe offertes en orders ontstaan. Dat blijft applicatielogica.
Voor 3D-content op het web zijn glTF en de binaire GLB-variant logische formaten. glTF is bedoeld als runtime asset delivery format — een manier om 3D-content efficiënt van authoringtools naar realtime applicaties te brengen — en een asset kan meshes, transforms, materialen, textures en scenegraph-data bevatten. Three.js ondersteunt glTF via een officiële loader. Een GLB-bestand is daarmee niet automatisch web-geoptimaliseerd: het kan nog steeds veel te veel geometrie bevatten, enorme textures gebruiken, tientallen unieke materialen hebben, onnodige interne onderdelen meedragen of slecht gestructureerd zijn voor realtime gebruik. Het bestandsformaat lost de assetoptimalisatie dus niet op.
Veel bedrijven hebben al CAD-modellen van hun producten. Dat is waardevol, maar CAD heeft een ander doel dan realtime browservisualisatie: engineeringmodellen bevatten toleranties, bevestigingsmateriaal, interne componenten, zeer fijn detail en zware assemblies. Die informatie kan essentieel zijn voor productie en volledig irrelevant voor de gebruiker. Een volwassen CAD-to-web-pipeline bestaat daarom uit tesselleren, onzichtbare geometrie verwijderen, detail vereenvoudigen, meshstructuren rationaliseren, herhaalde delen instancen, materialen samenvoegen waar mogelijk, textures verkleinen en comprimeren en eventueel meerdere LOD-versies maken. De beste pipeline hangt af van het product; een universele regel als "ieder model moet onder X polygonen blijven" bestaat niet.
Wat performance werkelijk bepaalt
Renderingkosten worden niet alleen door geometrie bepaald. Draw calls, het aantal materialen, texturegrootte, shadercomplexiteit, renderresolutie, transparantie, effecten, het aantal objecten en het GPU-geheugen spelen allemaal mee. Een scène met minder polygonen kan slechter presteren dan een rijkere scène wanneer er veel losse materialen en zware textures nodig zijn. Performance hoort daarom te worden gemeten op de volledige representatieve scène, niet op één getal uit een modelbestand.
Iedere afzonderlijke renderoperatie kost overhead. Bestaat een product uit honderden losse onderdelen met unieke materialen, dan kan het aantal draw calls snel oplopen. Mogelijke optimalisaties zijn geometrie logisch samenvoegen, materialen hergebruiken, instancing voor herhaalde objecten, onzichtbare delen niet renderen en de scenecomplexiteit per configuratie beperken. Welke strategie het beste werkt, hangt af van hoe dynamisch het product is: te agressief samenvoegen kan configuratie juist moeilijker maken wanneer individuele onderdelen onafhankelijk zichtbaar of veranderbaar moeten blijven. Performanceoptimalisatie hoort dus samen met productgedrag te worden ontworpen.
Texturegebruik is een apart aandachtspunt. Hoge resoluties vragen snel veel GPU-geheugen, zeker wanneer per materiaal meerdere maps worden gebruikt voor base color, normal, roughness, metallic en ambient occlusion. Technieken als mipmapping en GPU-compressed textures zijn dan relevant; Three.js ondersteunt bijvoorbeeld KTX2-loading, en Basis Universal kan een gecomprimeerde bron tijdens het laden naar een geschikt GPU-formaat transcoderen. Dat is vooral op mobiel belangrijk, waar geheugen en bandbreedte beperkter kunnen zijn.
Level of Detail — afhankelijk van afstand of context een eenvoudiger model gebruiken — kan nuttig zijn bij grote scènes, veel modules, producten die ver van de camera kunnen staan en uitgebreide omgevingen. Three.js heeft daarvoor een LOD-mechanisme. Bij één relatief compact product dat altijd dichtbij wordt bekeken, levert een goede basisasset met een efficiënte materiaalopzet vaak meer op dan meerdere LOD-versies. LOD is een techniek, geen verplicht vinkje.
Een configurator hoeft daarnaast niet alle mogelijke assets bij de eerste page load binnen te halen. Beter is het basisproduct en de noodzakelijke interface laden, de eerste bruikbare configuratie tonen, minder waarschijnlijke materiaalsets of modules later laden en assets cachen voor vervolginteractie. Het doel van die progressive loading is niet alleen een lager totaal aantal megabytes, maar vooral een kortere tijd tot de gebruiker iets bruikbaars kan doen. Omdat 3D-assets minder vaak veranderen dan configuratiestate of gebruikersdata, lenen GLB's, textures en environments zich goed voor versioned URLs, content hashes, browser caching en CDN-delivery, terwijl dynamische data als prijsresultaten en gebruikersconfiguraties een andere cachepolicy vraagt. Een goede configurator behandelt statische assets en dynamische bedrijfsdata dus niet als hetzelfde soort content.
Mobiel vraagt een eigen kwaliteitsstrategie
Een desktopconfigurator responsive maken met CSS is niet genoeg. Mobiele apparaten hebben minder GPU-marge, beperkter geheugen, een hoge device-pixel-ratio, touchinteractie, minder schermruimte en grotere onderlinge verschillen. Een praktische strategie is kwaliteit aanpassen aan de beschikbare context: een lagere renderresolutie, kleinere textures, minder zware effecten, eenvoudiger geometrie, minder decoratieve scene-elementen en een lagere detailvariant. Dat werkt vaak beter dan één vaste kwaliteitsinstelling voor ieder apparaat.
Ook de UX moet anders worden ontworpen, want touch is geen muis. Een draggesture om de camera te draaien kan botsen met paginascroll, en hover bestaat niet als betrouwbaar primair interactiepatroon. Belangrijke productkeuzes horen daarom niet uitsluitend af te hangen van precieze objectselectie in de 3D-scène; de configuratie moet ook op kleinere touchscreens duidelijk en controleerbaar blijven.
Verantwoordelijkheden verdelen tussen frontend en backend
Een professionele architectuur verdeelt het werk logisch. De frontend verzorgt stappen, keuzecomponenten, foutmeldingen, helpteksten en touchbediening. De configuratiestate houdt de actuele keuzes en afgeleide waarden bij. De rule engine bewaakt de geldigheid van states en combinaties, de pricing engine berekent prijscomponenten, formules en totalen, en de 3D-renderer vertaalt state naar geometrie en materialen. De backend of API verzorgt persistency, sessies, finale validatie, integraties en documenten; de database bewaart productdata, regels, prijzen, configuraties en versies; de admin maakt beheerbare data wijzigbaar en publiceerbaar; en de integratielaag verbindt CRM, ERP, webshop, calculatie, offerte en order.
Dat betekent niet dat ieder blok een afzonderlijke microservice moet worden. Bij een compacte maatwerkapplicatie kunnen meerdere verantwoordelijkheden in één backend of codebase zitten. Het doel is conceptuele scheiding, geen technische over-engineering. Hoe je zo'n architectuur beoordeelt zonder zelf developer te zijn, staat in technische kwaliteit beoordelen.
De browser is bovendien een onbetrouwbare omgeving als enige autoriteit voor een commercieel bindende transactie. Bij offerte- of orderverzending is het verstandig opnieuw te controleren of deze configuratie geldig is, of het product nog bestaat, of deze prijzen nog gelden, of deze combinatie voor deze klant of markt is toegestaan en of de berekende prijs reproduceerbaar is. De frontend blijft belangrijk voor directe feedback, maar de finale beslissing hoort op een gezaghebbende laag te worden bevestigd.
Opslaan, versiebeheer en beheer
Zodra configuraties later opnieuw geopend kunnen worden, ontstaat een klassiek probleem: welke productregels en prijzen golden toen? Drie concepten helpen daarbij. De productdefinitieversie legt vast welke opties, regels en productstructuur op dat moment golden. De configuratiestate legt vast wat de gebruiker daadwerkelijk koos. En een prijssnapshot legt vast welke prijscomponenten toen zijn berekend. Zonder dat onderscheid kan een oude offerte ongemerkt veranderen wanneer een beheerder later een materiaalprijs of productregel wijzigt.
Save & resume lijkt daarom technisch eenvoudig — sla de state op en laad hem later terug — maar wanneer producten veranderen moet het systeem beslissen wat er met oude configuraties gebeurt. Een optie kan niet meer bestaan, een prijs kan gewijzigd zijn, een regel aangescherpt of een productfamilie kan een nieuwe versie hebben. Een opgeslagen configuratie verwijst daarom bij voorkeur naar de relevante product- of regelversie, zodat het systeem expliciet met oude states kan omgaan in plaats van ze stilzwijgend volgens nieuwe regels te interpreteren.
Een goede beheeromgeving kan onderhoud sterk vereenvoudigen, maar "alles zelf beheerbaar" is geen neutrale requirement. Veilig beheerbaar zijn doorgaans teksten, labels, volgorde, eenvoudige prijzen, een product actief of inactief zetten, kleuren en materialen binnen bestaande slots en eenvoudige minimum- en maximumwaarden. Fundamentelere veranderingen blijven vaak ontwikkelwerk: nieuwe parametrische geometrie, een nieuw type constraint, een nieuw prijsalgoritme, gewijzigde shaderlogica of een complexe nieuwe ERP-mapping. Hoe vrijer het beheer, hoe meer validatie, rechten, preview, versiehistorie en foutafhandeling nodig zijn.
Integraties draaien om data ownership
Veel configurators moeten uiteindelijk koppelen met CRM, ERP, webshop, calculatie, offerte, ordermanagement of een documentservice. De belangrijkste vraag is niet of je een API kunt koppelen, maar welk systeem welke waarheid bezit. Het ERP beheert materialen, de configurator beheert de actuele gebruikerskeuze, een pricing service berekent de commerciële prijs, het CRM beheert klantstatus en ordermanagement beheert orderstatus. Wordt hetzelfde gegeven in meerdere systemen onafhankelijk onderhouden, dan ontstaat drift. Een goede integratiearchitectuur voorkomt dat drie systemen elk hun eigen versie van dezelfde waarheid hebben; een API-koppeling laten maken gaat dieper in op wat daarvoor nodig is.
Een integratie is bovendien sterker wanneer het datacontract expliciet is. Naar een CRM kunnen contactgegevens, een configuratie-ID, een deeplink naar de configuratie, het gekozen product, een geschatte waarde en leadstatus gaan. Naar een ERP zijn andere gegevens relevant: artikelcodes, materialen, aantallen, componenten, ordergegevens en productie-informatie. Het is dus niet genoeg dat een configurator "met ERP kan koppelen" — de vertaalslag tussen productkeuze en downstream datastructuur is onderdeel van het ontwerp.
Offerte en order zijn daarbij verschillende technische eindpunten. Een configurator kan eindigen bij visualiseren, bij een opgeslagen configuratie, bij een lead, bij een offerteaanvraag, bij een automatische offerte, bij checkout, bij orderintegratie of bij productie-output. Iedere stap verhoogt de eisen: een offerteaanvraag laat ruimte voor controle door een medewerker, terwijl een directe order veel meer zekerheid vraagt over productgeldigheid, prijs, beschikbaarheid, commerciële voorwaarden en downstream mapping. Het gekozen eindpunt hoort daarom vroeg in de architectuur bekend te zijn.
Testen bij duizenden combinaties
Configurators hebben snel een combinatorisch testprobleem. Wanneer meerdere opties onafhankelijk of conditioneel kunnen variëren, zijn alle mogelijke states al gauw te veel om handmatig door te klikken. Daarom is het verstandig regels en prijslogica zoveel mogelijk los testbaar te maken: minimum- en maximumwaarden, requires en excludes, familiespecifieke uitzonderingen, prijsformules, afgeleide waarden, ongeldige states, oude configuratieversies en integratiemappings. De 3D-weergave zelf blijft daarnaast visueel getest worden, maar een renderer-screenshot bewijst niet dat de productlogica klopt.
Veelgemaakte architectuurfouten
De meest voorkomende fout is eerst het 3D-model bouwen en de regels later uitzoeken; dan wordt de visualisatie gebouwd rond een nog onduidelijk productdomein, terwijl je beter eerst parameters, afhankelijkheden en gewenste output kunt modelleren. Verwant daaraan is het gebruik van de scene graph als productmodel, waarbij meshes impliciet commerciële betekenis krijgen in plaats van dat de canonieke configuratiestate de bron is. Ook het hardcoden van productregels in UI-componenten werkt lokaal, maar maakt hergebruik in backend, orderflow of andere interfaces lastig — regels verdienen een eigen domein.
Prijsberekening pas aan het einde ontwerpen is riskant, omdat calculatie een van de complexste onderdelen van het product kan zijn; valideer het prijsmodel al tijdens discovery. CAD rechtstreeks publiceren gaat voorbij aan het feit dat een engineeringmodel niet geschikt is voor realtime webgebruik, en alleen een polygonbudget hanteren negeert dat polygonen maar één performancefactor zijn — meet de volledige scène op representatieve hardware. Alleen op desktop testen verbergt verschillen in mobiele GPU-capaciteit, geheugen en bediening, dus hoort daar een expliciete testmatrix met quality scaling bij. Zonder versiebeheer voor opgeslagen configuraties kunnen oude offertes van betekenis veranderen, waardoor productversie, state en prijsresultaat onderscheiden moeten worden. En integraties pas na de frontend bedenken laat een mooie configurator alsnog in handmatig copy-pastewerk eindigen; neem downstream data en ownership vanaf het begin mee.
Een goede architectuur begint bij het productmodel
De meest zichtbare laag van een 3D-productconfigurator is de renderer, maar de kwaliteit van het systeem wordt vooral bepaald door wat daaronder zit: een expliciete configuratiestate, betrouwbaar gemodelleerde productregels, afgeleide waarden, afgebakende prijslogica, heldere data ownership, versiebeheer, reproduceerbare validatie, een webgerichte assetpipeline en meetbare performance op echte apparaten.
Een goede configurator begint daarom niet bij de vraag welke 3D-engine je gebruikt, maar bij de vraag welke productwaarheid het systeem moet modelleren, valideren en doorgeven. Pas daarna komt de keuze hoe die waarheid het beste in 3D wordt weergegeven. Wanneer zo'n systeem zakelijk zinvol is, lees je in wanneer een 3D-productconfigurator zinvol is; wil je de mogelijkheden voor je eigen product verkennen, kijk dan bij 3D-configurator laten maken.
Bronnen
Dit artikel is gebaseerd op technische documentatie en onderzoek naar browsergebaseerde 3D-rendering, glTF, constraint-based productconfiguratie en CPQ-architectuur.